Les RFC (Request For Comments) sont les documents de référence de l'Internet. Produits par l'IETF pour la plupart, ils spécifient des normes, documentent des expériences, exposent des projets...
Leur gratuité et leur libre distribution ont joué un grand rôle dans le succès de l'Internet, notamment par rapport aux protocoles OSI de l'ISO organisation très fermée et dont les normes coûtent cher.
Je ne tente pas ici de traduire les RFC en français (un projet pour cela existe mais je n'y participe pas, considérant que c'est une mauvaise idée), mais simplement, grâce à une courte introduction en français, de donner envie de lire ces excellents documents. (Au passage, si vous les voulez présentés en italien...)
Le public visé n'est pas le gourou mais l'honnête ingénieur ou l'étudiant.
RFC 10080: Updated Use of the Expires Message Header Field
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : B. Billon (Splio), J. Levine
(Standcore)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF mailmaint
Première rédaction de cet article le 31 octobre 2026
Ce RFC
normalise le champ Expires: dans l'en-tête d'un
message. Il
existait déjà mais n'avait apparemment jamais été spécifié
officiellement. Il indique quand un message cesse d'être
utile et n'a plus besoin d'être montré.
L'utilisation envisagée est que le MUA peut déclasser un message expiré, voire le masquer complètement (le détruire n'est pas recommandé, un message expiré n'est plus valide mais peut garder, par exemple, un intérêt historique). Notre RFC n'essaie pas de donner une signification trop précise à ce champ, encore moins de requérir des actions spécifiques par le logiciel.
Donc, le champ garde sa syntaxe (section 3), la forme de la date-et-heure étant tirée du RFC 5322, section 3.3 :
Expires: Thu, 16 Jul 2026 11:28:03 +0000
(Si vous utilisez le logiciel GNU date, l'option
--rfc-email permet d'afficher une date-et-heure
au bon format.)
On l'a dit, ce RFC n'est pas trop normatif, mais il donne quand
même des avis. La section 4 conseille aux logiciels de création de
messages de mettre un Expires: quand on sait
que le message perdra son intérêt après un certain moment. C'est par
exemple le cas d'une promotion commerciale qui a une date de fin,
d'un message qui annonce un évènement ou d'un message périodique,
qui n'est valable que jusqu'à l'émission du suivant.
La section 5, elle, consacrée aux logiciels de lecture, leur
suggère de diminuer la priorité d'affichage des messages expirés,
voire de ne pas les montrer du tout. Elle estime qu'il ne faut pas
refuser un message uniquement sur la base du champ
Expires:, et ne pas, par défaut, détruire les
messages expirés (mais on peut avoir une option du logiciel pour
activer cette destruction).
On notera qu'il existe un projet Email Expiration
Date pour développer l'utilisation du champ
Expires:. Ce projet, porté par plusieurs
acteurs spécialisés dans l'envoi massif de messages, a développé
un
greffon Thunderbird mettant en œuvre l'expiration des
messages. Jusqu'à présent, je n'ai vu ce champ dans des vrais
messages que dans les spams de la SNCF, par
exemple un message expédié en juin qui indiquait Expires:
Monday, 21 December 2026 14:38:28 +0000 (cette date était
sans rapport avec le contenu de la publicité, mais était à six mois
dans le futur donc je suppose qu'un Expires:
d'une demi-année est mis automatiquement).
Ce champ Expires: a une histoire. Le RFC 1327 décrit déjà, dans le contexte de
l'interopérabilité avec X.400, un champ
Expiry-date:. Le RFC 2156 le renomme Expires:, en
indiquant juste sa syntaxe (une date-et-heure, au format du - à
l'époque - RFC 822) et peu de sémantique à
part qu'on ne pouvait pas compter que ce champ soit appliqué
automatiquement. Puis le RFC 4021 l'a placé
dans le
registre de l'en-tête du courrier. Notez qu'un autre format,
celui des News, a un champ
Expires: (RFC 5536,
section 3.2.5), avec une syntaxe et une sémantique proche. Comme,
dans le contexte du courrier
électronique, ce champ existe depuis longtemps, mais
avec peu ou pas de spécification, il aurait été difficile de définir
une spécification stricte, cela aurait cassé certains usages
existants (cf. section 6).
L'article seul
RFC 10055: Configuring UDP Sockets for Explicit Congestion Notification (ECN) for Common Platforms
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : M. Duke (Google)
Pour information
Réalisé dans le cadre du groupe de travail IETF tsvwg
Première rédaction de cet article le 16 octobre 2026
Un RFC un peu inhabituel que voici. Il ne spécifie pas un protocole ou un format, il explique simplement comment activer la notification de congestion (ECN) sur les systèmes d'exploitation courants.
Cette notification (ECN = Explicit Congestion Notification) est normalisée dans le RFC 3168 et permet de signaler en aval de la machine qui met l'ECN qu'elle voit de la congestion. Elle est surtout utilisée avec TCP (où, de toute façon, c'est le noyau qui s'en occupe) mais la normalisation de QUIC (RFC 9000) a suscité davantage d'intérêt pour son utilisation avec UDP, où l'application doit gérer cela elle-même. Apparemment, un certain nombre de programmereuses ne savent pas bien comment mettre de l'ECN sur UDP donc l'auteur de ce RFC a testé pour vous, dans le cadre du développement de Chromium, sur Linux, FreeBSD, macOS et Windows (par la suite, je vais surtout parler de Linux car c'est ce que j'ai testé ; voyez le RFC pour les autres systèmes). Le code de Chromium est en ligne.
Si vous avez la flemme de relire le RFC 3168, il définit deux bits pour l'ECN, qui se trouvent après le champ DSCP (Differentiated Services Code Point, RFC 2474, l'octet qui les contient était appelé ToS - Type of Service - au millénaire précédent) de l'en-tête IP. Si ces deux bits sont à 1, c'est que de la congestion a été vue. (Les options UDP du RFC 9868 sont autre chose, et ne sont pas dans la même couche.)
Outre l'UDP utilisé seul, ce RFC est une bonne lecture si vous mettez en œuvre QUIC (RFC 9000), ou SCTP sur UDP (RFC 9260). Pour ce dernier cas, il semble que ça n'ait pas encore été utilisé. Il y a aussi RTP sur UDP (RFC 6679 et RFC 8888).
Ce RFC ne développe pas de nouvelles API, il explique juste ce qu'on peut faire avec les API actuelles, en C et C++.
Donc, d'abord, si vous voulez recevoir les
notifications (section 3 du RFC), vous devez utiliser
setsockopt avec les options
IP_RECVTOS (en IPv4) ou
IP_RECVTCLASS (en
IPv6) :
result =
   setsockopt(socketfd, IPPROTO_IPV6, IPV6_RECVTCLASS, &enable, sizeof(enable));
Il faudra ensuite lire le paquet avec recvmsg et
utiliser les messages auxiliaires avec cmsg (type de
message IPV6_TCLASS) :
  numbytes = recvmsg(socketfd, &mh, 0);
  for (struct cmsghdr * cmsg = CMSG_FIRSTHDR(&mh);
             cmsg != NULL; cmsg = CMSG_NXTHDR(&mh, cmsg)) {
     if (cmsg->cmsg_level != IPPROTO_IPV6 || cmsg->cmsg_type != IPV6_TCLASS) {
                continue;
     }
     tclass = (int *) CMSG_DATA(cmsg);
(Dans le monde Apple, il faudra plutôt lire leur documentation.)
Et pour envoyer de l'ECN ? La section 4 du
RFC nous dit qu'il faut utiliser
setsockopt pour indiquer la valeur
(apparemment, il faut écrire l'octet complet, DSCP et ECN) :
  result = setsockopt
            (sd, IPPROTO_IPV6, IPV6_TCLASS, &dscp_value, sizeof(dscp_value))
Si vous voulez le code complet, je l'ai mis dans les programmes
udp-ecn-sender.cudp-receiver.c
% make udp-ecn-receiver
cc     udp-ecn-receiver.c   -o udp-ecn-receiver
% ./udp-ecn-receiver
et dans une autre fenêtre :
% make udp-ecn-sender
cc     udp-ecn-sender.c   -o udp-ecn-sender
% ./udp-ecn-sender --verbose ::1
Connecting to ::1 port 4242...
Sending 11 bytes with DSCP 3...
et on voit dans la première fenêtre :
Message received, 11 bytes.
Received DSCP 3
Analysé avec tshark, cette communication montre :
Frame 1: 73 bytes on wire (584 bits), 73 bytes captured (584 bits)
…
Internet Protocol Version 6, Src: ::1, Dst: ::1
…
     .... 0000 0011 .... .... .... .... .... = Traffic Class: 0x03 (DSCP: CS0, ECN: CE)
          .... 0000 00.. .... .... .... .... .... = Differentiated Services Codepoint: Default (0)
        .... .... ..11 .... .... .... .... .... = Explicit Congestion Notification: Congestion Experienced (3)
On voit bien que l'expéditeur a dit qu'il voyait de la
congestion. Vous pouvez jouer avec l'option
--ecn de l'expéditeur pour essayer d'autres
valeurs que 3 (les deux bits ECN à 1).
Ces programmes devraient (?) fonctionner sur FreeBSD (mais je n'ai pas testé). Si vous les portez sur Rust ou Zig, le résultat m'intéresse.
L'article seul
RFC 10050: Protocol-Specific Profiles for JSContact
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : R. Stepanek (Fastmail), M. Loffredo (IIT-CNR)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF calext
Première rédaction de cet article le 24 septembre 2026
La norme JSContact décrit un modèle de données et un format pour stocker des informations de contact sur une entité (personne physique ou morale). Elle est riche, avec beaucoup d'informations dont toutes les applications n'ont pas forcément besoin. Ce RFC normalise la notion de profil : un profil est une spécialisation de JSContact, indiquant les éléments obligatoires et les autres. Un nouveau registre IANA stocke les profils existants.
JSContact est normalisé dans le RFC 9553. Il peut servir par exemple comme modèle de données et format pour un carnet d'adresses, ou dans des protocoles d'accès à l'information sur les contacts d'un objet enregistré, comme RDAP (RFC 9083). On peut échanger du JSContact avec des protocoles comme CardDAV (RFC 6352) ou JMAP (RFC 9610). JSContact vise à remplacer vCard (RFC 6350) et sa déclinaison jCard (RFC 7095), complexes et difficiles à traiter.
Mais JSContact a ses propres complications ; comme il a un modèle de données riche, pour pouvoir gérer tous les cas prévisibles, une mise en œuvre de JSContact doit traiter des données même quand l'application n'en a pas l'usage (sans compter les problèmes de vie privée que peut poser cette absence de minimisation des données). Le RFC 9553 permet d'ignorer certaines données, mais uniquement celles d'extension de JSON, pas les données du cœur.
La solution de notre RFC est de permettre la définition de profils, un profil étant une définition de ce qui est nécessaire dans un objet JSContact. Ainsi, une application qui n'a besoin que de peu de données peut utiliser JSContact au lieu de définir son propre format. Le registre central permettra de trouver et de référencer facilement les profils. (Aujourd'hui, aucun n'est enregistré.)
Un profil est donc un ensemble d'éléments JSContact, stocké dans le registre IANA. Il a un nom (restreint à ASCII). Notez bien qu'un même objet JSContact peut être valide selon plusieurs profils et c'est pour cela que le profil n'est pas affiché dans l'objet.
Un profil liste plusieurs propriétés, qui ont notamment un nom, un contexte (à quel type d'objets s'applique le profil), des restrictions sur les attributs… Par exemple, cette propriété :
 Property Name: kind Property Context: Card Restricted Enum
  Values: individual,org
s'applique aux objets
Card et dit que kind (RFC 9553, section 2.1.4) ne peut être que
individual ou org (et pas,
comme normalement en JSContact, group,
application, etc).
Je l'ai dit, le registre actuel est vide donc, pour avoir des exemples, il faut regarder les annexes A.1, A.3 et A.4 (profil) ainsi que A.2 (objet JSContact correspondant à ce profil) du RFC. Pour ajouter des profils au registre, la politique à suivre (RFC 8126) est « Spécification nécessaire ».
L'article seul
RFC 10049: Roughtime: A Protocol for Rough Time Synchronization
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : W. Ladd (Akamai
Technologies), M. Dansarie
(Netnod)
Expérimental
Réalisé dans le cadre du groupe de travail IETF ntp
Première rédaction de cet article le 7 octobre 2026
Dernière mise à jour le 14 octobre 2026
Ce nouveau protocole de synchronisation d'horloges, Roughtime est, officiellement, encore expérimental. Deux de ses buts essentiels sont la possibilité d'une synchronisation sécurisée (avec de la cryptographie, donc), même quand le client n'a aucune idée de l'heure et du jour, et un moyen de signaler les erreurs et problèmes rencontrés. Il concernera notamment les objets connectés qui, souvent, n'ont pas de batterie pour garder l'heure pendant un arrêt.
Si vous connaissez NTP (RFC 5905), vous savez qu'il n'offre pas de solution à ces deux problèmes. Roughtime est donc une alternative à NTP. Par contre, Roughtime, comme son nom l'indique, ne donne qu'une heure assez approximative.
La synchronisation des horloges est un problème très ancien sur l'Internet (cf. RFC 738). Elle est à la fois cruciale, notamment en sécurité, et très difficile à réaliser. Pour comprendre son importance en sécurité, pensez par exemple à l'estampillage de journaux. Ou aux signatures DNSSEC. Ou à TOTP (RFC 6238). Ou encore à la vérification qu'un certificat n'est pas expiré. Mais c'est justement aussi cela qui rend difficile de la sécuriser. NTP a un mécanisme de sécurité, NTS, normalisé dans le RFC 8915, mais qui dépend d'un certificat, donc d'avoir l'heure correcte. C'est un intéressant problème d'œuf et de poule : pour vérifier le certificat du serveur de temps, vous avez besoin de connaitre l'heure, justement ce que vous vouliez demander au serveur (section 6 du RFC).
Roughtime, spécifié dans ce RFC 10049, résout le problème en partant d'une liste de serveurs et de leurs clés publiques. Celles-ci sont censées durer assez longtemps pour que, dans la liste des serveurs, il y en ait plusieurs qui soient correctes. En prime, l'utilisation de réponses signées par les serveurs Roughtime permet à un client de prouver à un tiers qu'un serveur est malveillant (ou complètement déconnant ; on ne peut pas distinguer les deux cas). Le client obtient cette preuve en chainant les réponses de plusieurs serveurs. J'insiste : si on n'utilise qu'un seul serveur Roughtime, le client ne peut pas être sûr que l'heure obtenue est correcte. La sécurité ne vient que lorsqu'on a « suffisamment » de serveurs. (Évidemment, s'ils sont tous malveillants ou déconnants, on est fichu. Comme dit lors d'une discussion IETF, « Ideally, you would use 3 servers run by 3 different organizations using 3 different software implementations running on 3 different operating systems in 3 different well guarded buildings in 3 different countries... ».) Cette possibilité de prouver à un tiers qu'un des serveurs ne servait pas l'heure correcte est une importante différence avec un autre concurrent de NTP, Khronos (RFC 9523).
Ce RFC décrit le format des paquets et le protocole mais pour que Roughtime sorte de son statut expérimental, il faudra aussi déployer un écosystème de serveurs et un mécanisme pour obtenir une liste (avec les clés, souvenez-vous). Aucune méthode n'est prévue pour l'instant pour changer les clés, il faudra donc vraiment qu'elles durent longtemps, ou que l'objet connecté puisse facilement mettre à jour de manière sécurisée sa liste de serveurs.
La section 3 du RFC décrit le protocole en termes généraux. Signer les réponses n'est pas suffisant car il faut aussi que la réponse dépende de la requête du client (pour qu'il s'assure qu'on ne lui serve pas une vieille réponse rassise) et qu'on puisse la chainer avec celle des autres serveurs, pour qu'un tiers puisse repérer le serveur qui ne répond pas correctement. S'il n'y a qu'un serveur utilisé, le client peut tout juste vérifier que le message est correctement signé, et correspond à la question (celle-ci inclut un numnique) mais s'il y en a plusieurs (au moins trois), le client peut les comparer et repérer un serveur qui est trop à l'écart (que ce soit par erreur ou par malveillance, en général, on ne peut pas distinguer les deux) et il peut prouver à des tiers cette déviation. Une fois le serveur anormal repéré, on peut le signaler sur un forum, le faire virer des listes de serveurs qui circulent, etc.
La section 4 décrit le format des messages. Parmi les points à noter, la notion d'étiquette (tag). Les valeurs transportées sont toutes étiquetées, chaque étiquette étant sur quatre octets, en général choisis pour être une valeur en ASCII. NONC va ainsi indiquer que la valeur qui suit est le numnique (nonce), VER (avec un octet nul à la fin) indique la version (actuellement version 1), etc. Les étiquettes connues figurent dans un registre IANA et on peut en ajouter selon la politique « Spécification nécessaire » du RFC 8126.
Autre notion cruciale, les valeurs temporelles (timestamp) sont un entier sur 64 bits, indiquant le nombre de secondes depuis le 1 janvier 1970. Le message complet est composé d'un nombre magique (0x4d49544847554f52, ce qui fait "ROUGHTIM"), du nombre de valeurs, d'une liste de décalages des valeurs, d'une liste d'étiquettes, puis des valeurs. Les deux listes sont triées selon l'ordre des étiquettes. La première valeur a pour décalage zéro.
Le message est ensuite transmis en UDP (avec du remplissage obligatoire pour éviter les attaques avec amplification, section 9.7 du RFC). L'algorithme cryptographique est forcément Ed25519, décrit dans le RFC 8032. Il n'y a pas d'agilité cryptographique - RFC 7696, il faudra changer de version du protocole pour, par exemple, passer à la cryptographie post-quantique (section 9.5). Dans une requête, les étiquettes VER (version du protocole), NONC (le numnique du client, qui doit évidemment être aussi imprédictible que possible, cf. RFC 4086) et TYPE (0 pour une requête) sont obligatoires. On peut y ajouter SRV, qui indique la clé publique que le client compte utiliser (cela permet au serveur, entre autres, de sélectionner la bonne clé si on en a plusieurs, mais aussi de voir qu'un client a toujours une vieille clé).
La réponse a les étiquettes NONC (celui qui avait été envoyé par le client), TYPE (1 pour une réponse), SIG (la signature du message), PATH (des valeurs d'un arbre de Merkle décrit plus loin), CERT (un certificat) et SREP (la partie utile de la réponse). La valeur associée à l'étiquette SREP est elle-même un message Roughtime avec notamment les étiquettes MIDP (l'heure sur le serveur, c'est-à-dire l'information principale pour le client), RADI (une estimation de la précision de l'heure, en secondes, donc la précision sera toujours rough, ±1s) et ROOT (la racine de l'arbre de Merkle des réponses, cf. section 5.3 du RFC). L'utilisation d'un arbre de Merkle dans les réponses permet au serveur d'éviter de signer chaque réponse : il peut se contenter de condenser chaque réponse (ce qui est plus rapide que de signer) et de signer seulement la racine de l'arbre. Merci au passage à Kim Minh Kaplan pour avoir corrigé de grosses erreurs dans les explications sur cet arbre.
On peut noter qu'il n'existe pas de réponse pour une requête erronée (pas de FORMERR comme dans le DNS ou de Kiss o' Death comme dans NTP). L'expérience de NTP (section 7.4 du RFC 5905, section 5.4 du RFC 8633 et section 8.3 et 8.7 du RFC 8915) est que cela facilite trop certaines attaques par déni de service en faisant croire qu'un serveur a un problème.
Pour éviter l'ossification du protocole, la section 7 du RFC demande de graisser (RFC 9170) les réponses en envoyant de temps en temps des réponses invalides (absence d'étiquettes obligatoires, par exemple, présence d'étiquettes non définies et surtout heures délibérément incorrectes mais avec des signatures invalides ; un client bien fait ignorera ces réponses - mais pourra réessayer, les autres se feront tromper).
Côté client, maintenant, le protocole prévoit que le client
vérifie les signatures et signale (par un moyen non normalisé) les
serveurs qui s'écarteraient trop des autres. La section 8.4 décrit
un format en JSON pour produire des rapports, au type
application/roughtime-malfeasance+json (avec un
exemple dans l'annexe B) mais, pour l'instant, il n'y a pas
grand'chose de spécifié et encore moins de déployé.
Notez que, si les réponses sont signées, Roughtime ne fournit en revanche aucune confidentialité.
Sur ma machine au logiciel pas tout à fait récent, Wireshark ne connait pas encore Roughtime mais, quand on analyse un paquet, on voit bien la liste des étiquettes (attention, la session utilisait une version temporaire du protocole, en cours de développement) :
Frame 10: 434 bytes on wire (3472 bits), 434 bytes captured (3472 bits)
…
User Datagram Protocol, Src Port: 2002, Dst Port: 47639
Data (392 bytes)

0000  52 4f 55 47 48 54 49 4d 7c 01 00 00 07 00 00 00   ROUGHTIM|.......
0010  40 00 00 00 44 00 00 00 64 00 00 00 64 00 00 00   @...D...d...d...
0020  a8 00 00 00 40 01 00 00 53 49 47 00 56 45 52 00   ....@...SIG.VER.
0030  4e 4f 4e 43 50 41 54 48 53 52 45 50 43 45 52 54   NONCPATHSREPCERT
0040  49 4e 44 58 73 d4 d3 56 32 f7 d1 03 28 31 35 bf   INDXs..V2...(15.
0050  18 14 ea 6e 62 74 99 58 ca b2 85 bf 1f 0b ca a1   ...nbt.X........
0060  4e 06 1c 4a ea 0b e0 9c 93 12 5b 7d 79 23 16 c3   N..J......[}y#..
0070  32 d9 41 d9 b0 94 5b 68 c0 e3 f1 c3 61 ab 00 6f   2.A...[h....a..o
0080  58 a8 d9 0c 0b 00 00 80 ac 90 f3 d2 69 b9 f8 d6   X...........i...
0090  7a 0d b7 37 42 e3 27 ab ed e3 fb d2 e8 41 f9 25   z..7B.'......A.%
00a0  75 de be 60 0a d6 59 80 03 00 00 00 04 00 00 00   u..`..Y.........
00b0  0c 00 00 00 52 41 44 49 4d 49 44 50 52 4f 4f 54   ....RADIMIDPROOT
00c0  03 00 00 00 3c 2c c6 6a 00 00 00 00 28 68 0c 3e   ....<,.j....(h.>
00d0  99 9c 8d c3 1c 86 9b 1f b9 05 4b 3d a5 92 0d 4c   ..........K=...L
00e0  48 4f a0 7c 16 ae e4 1e 0b 24 2e d1 02 00 00 00   HO.|.....$......
00f0  40 00 00 00 53 49 47 00 44 45 4c 45 cc 05 f4 6c   @...SIG.DELE...l
0100  56 46 12 eb 4d 45 47 c9 77 21 f4 9b 78 8f 46 2c   VF..MEG.w!..x.F,
0110  fa e1 08 8b 49 40 2e 70 e2 c3 15 f1 fe 2e 50 ab   ....I@.p......P.
0120  00 ab 77 18 3e f2 e0 56 7b 41 9a 39 78 de 4a e4   ..w.>..V{A.9x.J.
0130  aa 8d bf c8 79 b3 f9 86 75 8a 18 0f 03 00 00 00   ....y...u.......
0140  20 00 00 00 28 00 00 00 50 55 42 4b 4d 49 4e 54    ...(...PUBKMINT
0150  4d 41 58 54 b4 f2 07 3c f9 a5 f4 f0 d2 e5 03 51   MAXT...<.......Q
0160  1a cb b0 31 2f e3 cd 83 b7 14 ef 64 eb bb 9c 3b   ...1/......d...;
0170  4c 69 3a ea dc 8e c5 6a 00 00 00 00 5c e0 c6 6a   Li:....j....\..j
0180  00 00 00 00 00 00 00 00                           ........
    Data [truncated]: 524f55474854494d7c0100000700000040000000440000006400000064000000a80000004001000053494700564552004e4f4e4350415448535
2455043455254494e445873d4d35632f7d103283135bf1814ea6e62749958cab285bf1f0bcaa14e061c4aea0be09c93125b7d79231
    [Length: 392]
Voyons maintenant les mises en œuvre concrètes de ce protocole, côté client et côté serveur. D'abord, un avertissement : le RFC vient de sortir, le projet de norme a eu plusieurs itérations et vous trouverez donc en ligne divers programmes qui n'interagissent pas toujours entre eux (par exemple, le logiciel client de Cloudflare ne fonctionne pas avec le serveur public de Cloudflare). Il faudra donc attendre un peu que tout soit d'équerre. En attendant, jouons un peu. D'abord, le logiciel de Cloudflare, écrit en Go (vous pouvez aussi lire leur documentation) :
% git clone https://github.com/cloudflare/roughtime.git
% cd roughtime
% cd cmd/getroughtime
% go build main.go
% ./main
Either provide a configuration via -config or an address via -ping
Ah, c'est logique, rappelez-vous ce que j'ai écrit sur la liste de
serveurs (et leurs clés, cf. sections 8.1 et 8.3 du
RFC). getroughtime sait utiliser une liste écrite en JSON. Le RFC décrit le
format dans sa section 8.3, et on utilise le
type
application/roughtime-server+json si on la
distribue en ligne. Un exemple figure dans l'annexe A. Il y a une
liste fournie dans le logiciel, utilisons-la :
% ./main -config ../../ecosystem.json
skipped Cloudflare-Roughtime-2: protocol: response is missing NONC tag
skipped int08h-Roughtime: no reply
skipped roughtime.se: no reply
time.txryan.com: 2026-10-06 09:36:47 +0000 UTC ±3s (in 96ms)
Delta: -741ms
Bon, plusieurs des serveurs ne répondent pas, ou pas correctement selon les clients (ma remarque ci-dessus à propos des différentes versions qui trainent). Mais le dernier marche, et on a bien l'heure. Le même logiciel contient aussi un serveur de test :
% cd ../testserver
% go build main.go
% ./main
main.go:64: Root public key: zFVzPprRDxDOMdsrifp+/XPkVkDEhllv6QDJxOWWYd0=
Le serveur tourne (par défaut, sur
127.0.0.1:2002). Notez que le
port officiellement enregistré
à l'IANA est désormais 5319. Et le serveur nous affiche sa
clé. Essayons en indiquant cette clé :
% cd ../getroughtime
% ./main -ping localhost:2002 -pubkey zFVzPprRDxDOMdsrifp+/XPkVkDEhllv6QDJxOWWYd0=
Ping response: 2026-10-06 11:37:57.754243 +0200 CEST ±1s (in 1ms)
Parfait, tout va bien. Si on avait indiqué une mauvaise clé :
% ./main -ping localhost:2002 -pubkey kMe//FBOFOwPXjx8NYjPtkdlH94IoxAX98RDsiVXcEc=
Ping error: protocol: invalid delegation signature
Le client vérifie donc bien les signatures du serveur. Essayons avec un autre logiciel, écrit en C :
% git clone https://github.com/nahojkap/craggy.git
% cd craggy
% cmake -E make_directory ./build
% cmake -S . -B ./build/ -DCRAGGY_WITH_ORLP_ED25519_BINDINGS=ON
% cd build
% make
Le client ne fonctionne pas avec le serveur de test de Cloudflare (qui meurt avec « main.go:97: Error while handling request: no version in common: [] ») mais il marche avec au moins un serveur public :
% ./cli/craggy-cli -h  time.txryan.com:2002 -k iBVjxg/1j7y1+kQUTBYdTabxCppesU/07D4PMDJk2WA=

Received reply in 105898μs. (105ms)
Current time is 1791281389ms from the epoch, ±3s
System clock differs from that estimate by -796785μs. (-796ms)
Il existe aussi d'autres mises en œuvre que je n'ai pas testées,
chez
Google en Go, une autre en C
et une
dernière, en Clojure. Si vous cherchez
des serveurs publics pour tester, vous avez une
liste (pas à jour…) dans le code de Cloudflare. Ou bien vous
en trouvez quelque part sur le réseau, par exemple le serveur expérimental de SIDN. Je
copie la configuration qu'ils indiquent, je l'édite pour changer la
version en IETF-Roughtime (car le client testé ne
connait pas encore la version 1) et ça marche avec le logiciel de
Cloudflare :
% ./main -config /tmp/sidn.json
TimeNL-Roughtime: 2026-10-07 17:06:30 +0200 CEST ±3s (in 24ms)
Delta: -658ms
Autres lectures :
- L'explication de Cloudflare et la documentation du logiciel,
- une courte explication claire des buts du protocole par un des auteurs du RFC et une présentation qu'il avait faite au RIPE pendant le développement du protocole,
- la vidéo d'une autre présentation du projet,
- le résultat des tests du protocole à un hackathon de l'IETF en 2024,
L'article seul
RFC 10042: Post-Quantum/Traditional Hybrid Key Exchange with the Module-Lattice-Based Key-Encapsulation Mechanism for Use in SSH
Date de publication du RFC : Août 2026
Auteur(s) du RFC : P. Kampanakis (AWS), D. Stebila
(University of Waterloo), T. Hansen
(AWS)
Pour information
Réalisé dans le cadre du groupe de travail IETF sshm
Première rédaction de cet article le 31 août 2026
Tout le monde (et son chat) se met à la cryptographie post-quantique en ce moment et plus précisément à des systèmes hybrides, c'est-à-dire utilisant à la fois un algorithme traditionnel (comme ECDH) et un algorithme post-quantique (comme ML-KEM). Ce RFC décrit l'échange de clés avec un système hybride dans le protocole SSH.
Au début d'une connexion SSH (RFC 4251, section 1), les deux parties qui communiquent procèdent en effet à un échange de clés (section 7 du RFC 4253) afin de parvenir à un accord sur la clé partagée qui sera utilisée pour chiffrer la communication. Jusqu'à récemment, cet échange de clés était fait en utilisant un algorithme reposant sur les courbes elliptiques (RFC 5656 et RFC 8731), algorithme qui est vulnérable aux futurs calculateurs quantiques. Si des calculateurs quantiques réellement utilisables (les CRQC, Cryptographically Relevant Quantum Computers) apparaissent un jour, l'ancien algorithme devra être abandonné. Et on ne peut pas attendre pour voir si des CRQC deviennent réellement disponibles : des attaquants sont peut-être aujourd'hui en train d'enregistrer des sessions SSH, afin de les décrypter plus tard lorsqu'on aura enfin des CRQC (RFC 9958, section 1). Bref, il vaut mieux passer à des algorithmes post-quantiques dès maintenant.
Mais les algorithmes post-quantiques existants ne sont pas forcément sûrs face à la cryptanalyse ; on manque de recul à ce sujet. D'où l'idée de systèmes hybrides (RFC 9794), ou PQ/T (pour PostQuantum/Traditional) combinant algorithme post-quantique et algorithme traditionnel, et obligeant l'attaquant à casser les deux s'il veut décrypter la communication. (Si vous voulez creuser la question de la sécurité des systèmes hybrides, regardez « Security of Hybrid Key Encapsulation » et « Security of Hybrid Key Establishment using Concatenation ».) C'est ce genre de système que normalise notre RFC. Il est sûr face à un attaquant actif, même si ce dernier dispose d'un calculateur quantique ou bien s'il a trouvé une faille dans l'algorithme post-quantique.
Plus précisément, ce RFC va utiliser l'algorithme post-quantique ML-KEM avec un choix d'algorithmes traditionnels.
La section 2 du RFC décrit concrètement l'échange de clés avec le
système hybride (relire les RFC 4251 et RFC 4253 peut être utile). Le client SSH, au lieu
de commencer par SSH_MSG_KEXDH_INIT (RFC 4253) ou
SSH_MSG_KEX_ECDH_INIT (RFC 5656), envoie un message
SSH_MSG_KEX_HYBRID_INIT (valeur 30 dans le
protocole) qui contient la concaténation des deux clés du client. Et
la réponse, au lieu de SSH_MSG_KEXDH_REPLY ou
SSH_MSG_KEX_ECDH_REPLY sera un
SSH_MSG_KEX_HYBRID_REPLY (valeur 31 dans le
protocole) contenant la concaténation des deux clés du serveur. Le
choix du mécanisme hybride utilisé est indiqué dans le message
SSH_MSG_KEXINIT (RFC 4253, section 7.1) et peut valoir
mlkem768nistp256-sha256,
mlkem1024nistp384-sha384 ou
mlkem768x25519-sha256 (désormais enregistrés
à l'IANA). Rappelez-vous qu'on parle d'échange de clés (symétriques), pas
d'authentification, la réponse
SSH_MSG_KEX_HYBRID_REPLY contient aussi la clé
publique du serveur, celle qui sert à vérifier qu'on parle au bon
serveur, mais celle-ci n'est pas concernée par ce RFC.
Le mécanisme hybride va nous donner deux secrets partagés, un pour chaque algorithme (le post-quantique et le traditionnel) et le secret qui servira (après dérivation) de clé pour le chiffrement symétrique est la concaténation de ces deux secrets (c'est très proche de ce que fait TLS, dans le RFC 9954).
Un problème classique de la cryptographie post-quantique est la taille des clés, bien plus importante qu'avec les algorithmes traditionnels. (L'hybride est même un tout petit peu plus grand, avec la clé traditionnelle.) SSH a des limites de taille (section 6.1 du RFC 4253) mais les algorithmes spécifiés dans notre RFC ne les atteignent pas.
La section 6 du RFC détaille les conséquences de ce schéma hybride sur la sécurité. Elle conseille par exemple d'utiliser X25519 (RFC 8731) plutôt que les courbes NIST comme P256, pour sa rapidité et sa meilleure résistance aux attaques par canal auxiliaire, sauf si on veut de la conformité plutôt que de la sécurité et qu'on doit utiliser les courbes NIST.
Côté mise en œuvre de ce système hybride,
OpenSSH le connait (ssh -Q
kex pour avoir la liste des algorithmes connus)
et, depuis la version
10.4, « the hybrid post-quantum algorithm
mlkem768x25519-sha256 is now used by default for key
agreement ». Par exemple :
% ssh -v something.bortzmeyer.org
debug1: OpenSSH_10.4p1, OpenSSL 3.6.3 9 Jun 2026
…
debug1: kex: algorithm: mlkem768x25519-sha256
debug1: kex: host key algorithm: ssh-ed25519
debug1: kex: server->client cipher: chacha20-poly1305@openssh.com MAC: <implicit> compression: none
debug1: kex: client->server cipher: chacha20-poly1305@openssh.com MAC: <implicit> compression: none
debug1: expecting SSH2_MSG_KEX_ECDH_REPLY
debug1: SSH2_MSG_KEX_ECDH_REPLY received
…
Hmmm, ça aurait dû être
SSH_MSG_KEX_HYBRID_REPLY, bizarre…
L'article seul
RFC 10037: Registration Data Access Protocol (RDAP) Extension for DNS Time-to-Live (TTL) Values
Date de publication du RFC : Août 2026
Auteur(s) du RFC : G. Brown (ICANN)
Chemin des normes
Première rédaction de cet article le 29 août 2026
Puisque le RFC 9803 étend le protocole d'avitaillement EPP pour ajouter des TTL spécifiques aux noms de domaine enregistrés, il était logique que le protocole d'interrogation RDAP permette d'obtenir cette information. C'est ce que permet l'extension normalisée dans ce nouveau RFC.
L'extension est simple, et le RFC court. RDAP permet d'obtenir des informations, structurées en JSON, sur divers objets enregistrés, comme les noms de domaine. Ces réponses (RFC 9083) peuvent inclure la valeur d'enregistrements DNS de type DS, NS, A ou AAAA mais, jusqu'à présent, pas leurs TTL (section 5 du RFC 9499, sur ce concept de TTL). Ce n'était pas trop grave tant que la quasi-totalité des registres imposaient le même TTL, choisi par eux, à toutes les données. Maintenant que le RFC 9803 normalise un moyen pour le client de choisir son TTL, cette limitation de RDAP était plus gênante.
Donc, concrètement, le serveur RDAP qui gère cette extension doit
ajouter une propriété ttl0_data aux objets de
type domaine (RFC 9083, section 5.3) et
serveur de noms (RFC 9083, section 5.2). Cette
propriété est un objet JSON comportant les membres
values et (facultativement)
remarks. values est un
dictionnaire indexé par le type
d'enregistrement, et dont les valeurs sont le TTL en secondes. C'est
le TTL tel qu'enregistré dans la base de données du registre, et pas
celui que verra une requête DNS auprès de votre résolveur, celui-ci étant la durée
restante dans la mémoire du résolveur. Voici l'exemple du RFC :
{
  "objectClassName": "domain",
  "rdapConformance": ["rdap_level_0", "ttl0"],
  "ldhName": "domain.example",
  "ttl0_data": {
    "values": {
      "NS": 3600,
      "DS": 300
    },
    "remarks": [
      {
        "description": [
          "For more information about the .example",
          " registry policy relating to DS record TTL changes,",
          "see https://domain.example/policy.html"
        ]
      }
    ]
  }
}
Et pour un serveur de noms enregistré (cf. RFC 5732) :
 {
  "objectClassName": "nameserver",
  "rdapConformance": ["rdap_level_0", "ttl0"],
  "ldhName": "ns1.domain.example",
  "ttl0_data": {
    "values": {
      "A": 86400,
      "AAAA": 86400
    },
    "remarks": [
      {
        "description": [
          "The .example registry does not permit TTL ",
          "values for nameservers to be changed."
        ]
     }
   ]
  }
}
Notez aussi le ttl0 dans le tableau
rdapConformance pour indiquer que le serveur
RDAP connait cette extension.
L'extension est désormais enregistrée à l'IANA. Quels logiciels la gèrent ? La bibliothèque RDAP de l'ICANN ainsi que la bibliothèque Perl Net::RDAP et son client rdapper.
Petit rappel important au passage : la section 5.2 du RFC 2181 impose que le TTL s'applique à un ensemble d'enregistrements (RRset, pour Resource Record Set) pas à un seul enregistrement. Ainsi, pour un ensemble NS, tous les enregistrements ont forcément le même TTL.
L'article seul
RFC 10033: Hash-based Signatures: State and Backup Management
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : T. Wiggers (PQShield), K. Bashiri
(BSI), S. Kölbl (Google), J. Goodman
(Crypto4A Technologies), S. Kousidis
(BSI)
Pour information
Réalisé dans le cadre du groupe de travail IETF pquip
Première rédaction de cet article le 15 septembre 2026
Certains algorithmes de cryptographie sont à état, c'est-à-dire que les programmes qui les utilisent doivent se souvenir des exécutions précédentes de l'algorithme ; refaire tourner l'algorithme dans les mêmes conditions serait une faille de sécurité. Cette nécessité de mémoriser un état complique évidemment leur utilisation. Ce nouveau RFC documente les bonnes pratiques à ce sujet.
La question des algorithmes à état est particulièrement cruciale dans le contexte de la cryptographie post-quantique. Un problème de beaucoup d'algorithmes post-quantiques est la grande taille de leurs clés et de leurs signatures, ce qui pose problème pour certaines applications sur l'Internet. Une solution possible serait d'utiliser des algorithmes comme ceux fondés sur la condensation, qui ont des clés et des signatures de taille plus raisonnable, et reposant sur ces algorithmes de condensation, qui sont bien connus. Mais ces algorithmes sont à état, ce qui est vraiment pénible à gérer.
Il existe plusieurs algorithmes dans cette famille fondée sur la condensation : LMS (Leighton–Micali Signatures), HSS (Hierarchical Signature System), XMSS (eXtended Merkle Signature Scheme), etc. Tous résistent aux futurs calculateurs quantiques mais tous ont un défaut : signer deux fois avec la même clé permet à la cryptanalyse de découvrir la clé privée. Il faut donc dériver une nouvelle clé à chaque signature et se souvenir des clés précédentes, pour ne pas risquer de réutilisation. C'est évidemment très contraignant et cela explique pourquoi, par exemple, ces algorithmes n'ont pas été sérieusement envisagés pour DNSSEC.
Si vous voulez vous instruire sur ces algorithmes utilisant la condensation, lisez les RFC 8391 (sur XMSS), RFC 8554 (sur LMS) et la norme NIST SP 800-208. Dans ces algorithmes, la clé privée est en fait une série de clés, partant d'une graine et créées par dérivations successives. L'état est simplement un index vers cette liste, indiquant la dernière clé utilisée. Si on réutilise une clé, on dévoile la graine. Il est donc très important de garder trace de l'index, de l'état. À chaque signature effectuée, il faut le mettre à jour. Imaginez par exemple un dispositif de signature qui signerait, diffuserait le message signé mais subirait ensuite une coupure de courant qui l'empêcherait de mettre à jour l'état. Une fois le courant revenu, la signature suivante utilisera le même index, donc la même clé et paf, le ou la cryptanalyste qui lira les deux signatures et connait la clé publique pourra trouver la graine, donc la clé privée. (Si ça vous semble magique, lisez « State Management for Hash- Based Signatures », « State management for stateful authentication mechanisms », « Oops, I did it again – Security of One-Time Signatures under Two-Message Attacks » et « Oops, I did it again revisited: another look at reusing one-time signatures ».) Notre RFC est donc consacré à décrire les mesures qui peuvent empêcher cette situation. Il faut s'assurer que l'état est bien mis à jour à chaque signature, que, dans le cas où il y a plusieurs signeurs, ils ne puissent jamais utiliser la même clé et que si on restaure les sauvegardes, on ne se trouve pas à réutiliser une clé. C'est compliqué ? Oui, et c'est pour cela que les algorithmes à état sont peu populaires. (Ils avaient été envisagés pour DNSSEC mais avaient fait peur à tout le monde.) Comme le note la section 1.1 du RFC, ces algorithmes ne conviennent pas pour un usage généraliste, il faut les réserver à des cas bien précis.
On peut même se demander pourquoi ces algorithmes n'ont pas été jetés à la poubelle tout de suite. C'est parce qu'ils ont quand même certains avantages, comme des tailles de clés et de signatures raisonnables. (DNSSEC, cité plus haut, ne peut pas envisager les énormes clés et signatures de ML-DSA.) Un exemple d'utilisation des systèmes à état est donné dans le RFC 9802.
La section 2 du RFC rappelle la terminologie utilisée. La clé privée à proprement parler est la graine dont dérivent les clés de signature. Elle-même est sans état et a potentiellement une longue durée de vie. Elle se gère comme n'importe quelle clé privée (donc, vous ne la mettez pas sur GitHub). L'état est au contraire à courte durée de vie et est mis à jour à chaque signature. Sa gestion (le mettre à jour, le sauvegarder, le distribuer…) est toute la difficulté des algorithmes de cryptographie à état.
Place à la pratique en section 3. Par exemple, les sauvegardes. Sauvegarder une clé qui peut servir pendant 10 ou 20 ans est une chose. Mais, ici, il faut sauvegarder du matériel cryptographique qui change tout le temps, puisque sauvegarder l'état est indispensable. La section 3.2 est une bonne lecture si vous vous intéressez aux questions de préservation de contenu numérique.
Mais il y a aussi le problème des procédures à suivre. Gérer des clés avec état est plus complexe et nécessite du personnel qualifié et consciencieux. Cela a des conséquences lorsqu'on calcule le coût total d'une solution cryptographique. D'autant plus que la sécurité peut nécessiter davantage de personnel, par exemple lorsqu'on déploie une solution M-sur-N pour contrer le risque d'une attaque menée de l'intérieur.
La section 4 liste les conséquences de ces exigences sous forme d'exigences ACID : la solution déployée doit permettre des transactions tout-ou-rien : l'utilisation de la signature et la mise à jour de l'état doivent être dans la même transaction (atomicité).
Suivre ces exigences en logiciel va être difficile : il peut y avoir une mémorisation de certaines informations, ce qui signifie que la version stockée sur un support stable n'a pas été mise à jour, il peut y avoir copie d'une machine virtuelle vers une autre, l'état étant alors dupliqué, etc. Le RFC conseille de plutôt utiliser un composant matériel dédié pour cette tâche délicate de maintien de l'état. Mais si vous voulez vraiment étudier la question en détail, et notamment les différents moyens d'atteindre nos objectifs, la section 5 discute de nombreuses solutions possibles.
Le RFC note aussi que ces exigences ne s'appliquent qu'au signeur. Le vérificateur des signatures, lui, peut complètement ignorer le problème et ne pas connaitre l'état.
L'article seul
RFC 10032: The AEGIS Family of Authenticated Encryption Algorithms
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : F. Denis (Fastly), S. Lucas
Pour information
Réalisé dans le cadre du groupe de recherche IRTF cfrg
Première rédaction de cet article le 19 septembre 2026
L'imagination des cryptologues est sans fin, voici une nouvelle famille d'algorithmes de chiffrement, fondés sur le classique AES, la famille AEGIS (qui, au moment d'écrire cet article, n'a pas encore de page Wikipédia). AEGIS permet de réutiliser le jeu d'instructions AES mais est plus rapide qu'AES et fournit du chiffrement intègre.
AEGIS est issu du concours CAESAR. Il existe en plusieurs versions, AEGIS-128, AEGIS-128L, AEGIS-128X, AEGIS-256 et AEGIS-256X (ils sont désormais dans le registre IANA des algorithmes de chiffrement intègre). Comme leurs noms l'indiquent, ces algorithmes diffèrent par la taille des clés utilisées mais tous utilisent les fonctions de base d'AES (norme NIST.FIPS.197-upd1), ce qui leur permet d'utiliser les mises en œuvre matérielles d'AES. AEGIS peut être vu comme de l'AES plus rapide.
En outre, AEGIS est normalement plus sûr qu'AES en mode GCM (les autres modes d'AES n'offrent pas de chiffrement intègre et ne sont donc pas vraiment comparables). Avec AES-GCM, on peut trouver des textes chiffrés qui se déchiffrent correctement avec plusieurs clés, ce qui facilite certaines attaques (cf. « Partitioning Oracle Attacks). Ce n'est pas possible avec AEGIS. D'autre part, la clé utilisée ne sert qu'au tout début, le chiffrement ou déchiffrement sera fait après une dérivation, on pourra donc effacer la clé de la mémoire rapidement, diminuant les risques qu'un méchant ne la copie.
Si vous voulez en savoir plus, ne comptez pas sur mes faibles connaissances en cryptographie, lisez les sections 2 à 8 du RFC, qui expliquent les algorithmes de la famille AEGIS, avec pseudo-code. Puis, pour approfondir, « Analyzing the Linear Keystream Biases in AEGIS », « Guess-and-Determine Attacks on AEGIS », « Weak Keys in Reduced AEGIS and Tiaoxin » ou « MILP-based security evaluation for AEGIS/Tiaoxin-346/ Rocca ».
AEGIS est aujourd'hui mis en œuvre dans plusieurs bibliothèques logicielles, dans de très nombreux langages de programmation. Si vous voulez contribuer à ces codes, ou bien en créer un nouveau, n'oubliez pas de tester avec les vecteurs de test de l'annexe A (également disponibles en ligne).
Les fans de cryptologie liront avec plaisir la section 9 qui analyse les problèmes de sécurité potentiels d'AEGIS. J'ai noté que cette section estime qu'AEGIS est résistant aux calculateurs quantiques, en tout cas s'il n'y a pas de lien quantique avec le système qui fait tourner AEGIS (ce qu'on appelle traditionnellement le « modèle Q1 d'attaquant », le modèle Q2 étant un attaquant complètement quantique).
L'article seul
RFC 10024: Post-Quantum Traditional (PQ/T) Hybrid Key Agreement Mechanisms for TLS 1.3
Date de publication du RFC : Août 2026
Auteur(s) du RFC : K. Kwiatkowski (PQShield), P. Kampanakis (AWS), B. E. Westerbaan (Cloudflare), D. Stebila (University of Waterloo)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF tls
Première rédaction de cet article le 20 août 2026
On met du post-quantique partout en ce moment. Ce court RFC normalise l'utilisation de clés hybrides (post-quantiques et traditionnelles) dans les échanges de clés de TLS.
Les trois mécanismes normalisés dans ce RFC utilisent tous ML-KEM, qui est normalisé dans FIPS-203. ML-KEM repose sur les réseaux euclidiens et les experts en cryptographie ne sont pas sûrs à 100 % de sa sécurité. Dans le doute, il est donc recommandé de l'utiliser combiné avec un algorithme traditionnel, comme décrit dans le RFC 9954. Ainsi, on est protégé à la fois contre les futurs CRQC (Cryptographically-Relevant Quantum Computer) et contre la cryptanalyse plus classique. Les principes de cette méthode hybride sont décrits en détail dans le RFC 9794 et le RFC 9954 déjà cité.
Les trois mécanismes d'échange de clés pour TLS normalisés ici (et qui sont appelés « groupes » pour des raisons historiques) sont :
- X25519MLKEM768, qui combine l'algorithme traditionnel à courbes elliptiques X25519 (RFC 7748) avec ML-KEM, et qui est le mécanisme recommandé.
- SecP256r1MLKEM768, qui combine SecP256 (norme FIPS-186, donc une courbe elliptique différente, la P256) avec ML-KEM, et qui a l'avantage ou l'inconvénient de n'utiliser que des algorithmes NIST.
- SecP384MLKEM1024, proche du précédent mais avec des clés plus longues et une courbe elliptique différente, avec normalement davantage de sécurité.
Pour les trois mécanismes traditionnels, avec des courbes elliptiques, l'algorithme ECDH est utilisé.
Pour réaliser l'échange de clés au début d'une session TLS, on fait tourner le mécanisme traditionnel et le post-quantique, et on concatène les deux clés. (Oui, je simplifie, que les experts en cryptographie m'excusent, la sortie d'ECDH utilisée n'est pas vraiment la clé.) On notera que, pour X25519MLKEM768, la clé faite via ML-KEM fait 1 184 octets et celle d'ECDH seulement 32 octets ; c'est un problème avec beaucoup d'algorithmes post-quantiques, dont les clés et les signatures sont très longues. (Et, oui, on n'utilise pas directement ces « clés » mais un dérivé.)
Si on se soucie de conformité plutôt que de sécurité, on lira avec bonheur la section 5 du RFC, qui décrit en détail la conformité de ce RFC avec les règles FIPS (c'est surtout utile si vous travaillez pour le gouvernement étatsunien).
Et si vous vous intéressez aux débats sur la sécurité de ML-KEM et sur le concept même d'hybride, parmi les nombreux articles publiés, je vous recommande celui de Sophie Schmieg.
Les trois mécanismes d'échange de clés ont été ajoutés au registre IANA, avec respectivement les numéros 4588, 4587 et 4589.
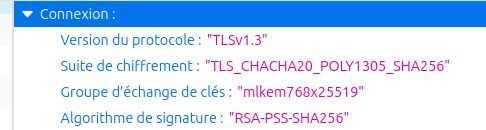
Voici, vus par Firefox (« Outils de développement Web » puis « Réseau » puis « Sécurité », tout au bout), les algorithmes cryptographiques utilisés avec un serveur HTTPS qui accepte un des mécanismes de notre RFC. Il y a en tout trois éléments à la liste car il faut trois choses pour faire du TLS :
- Un algorithme d'échange de clés (c'est le sujet de ce RFC), ici mlkem768x25519 (X25519MLKEM768 dans le RFC, c'est aussi ce qu'afficherait Chrome),
- Un algorithme d'authentification via une signature, ici RSA-PSS-SHA256 (c'est l'algorithme que vous trouverez dans le certificat),
- Un algorithme pour le chiffrement symétrique, une fois que les clés de session auront été échangées, ici ChaCha20 avec Poly1305.
Seul le premier des trois cités inclut du post-quantique. RSA
pourrait faire l'échange de clés (une des parties génère une clé de
session et la chiffre avec RSA avant de l'envoyer) et la signature
mais ML-KEM ne sait faire que l'échange de clés.
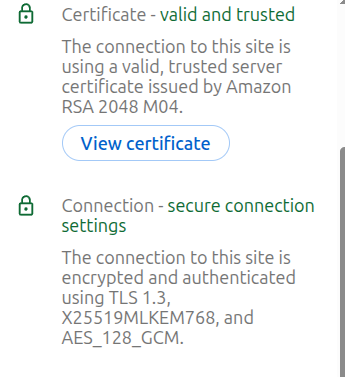
À part Firefox, Chrome gère ces nouveaux
mécanismes (qui sont déjà dans plusieurs
bibliothèques de cryptographie, cf. par
exemple la
liste de Cloudflare), ainsi que des hébergeurs comme
Cloudflare ou
AWS. Voici une connexion vue par Chrome :
Jouons un peu avec OpenSSL maintenant. On va utiliser la version qui est dans Debian stable. D'abord, créons un certificat pour ECDSA :
% openssl version
OpenSSL 3.5.4 30 Sep 2025 (Library: OpenSSL 3.5.4 30 Sep 2025)

% openssl ecparam -out server.pem -name prime256v1 -genkey

% openssl req -new -key server.pem  -nodes -out server.csr
…
Country Name (2 letter code) [AU]:FR
…

% openssl x509 -in server.csr -out server.crt -req -signkey server.pem -days 2001
Certificate request self-signature ok
subject=C=FR…
Maintenant qu'on a le certificat, lançons le serveur en lui disant qu'on accepte d'échanger les clés en X25519MLKEM768 (et qu'on écoute sur le port 12345) :
% openssl s_server -tls1_3 -groups X25519MLKEM768 -accept 12345 -cert server.crt -key server.pem
Firefox va pouvoir s'y connecter et affichera :
Version du protocole :	"TLSv1.3"
Suite de chiffrement :	"TLS_AES_128_GCM_SHA256"
Groupe d’échange de clés :	"mlkem768x25519"
Algorithme de signature :	"ECDSA-P256-SHA256"
Le serveur OpenSSL annonce quant à lui :
Shared ciphers:TLS_AES_128-GCM-SHA256:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-AES256-SHA:ECDHE-ECDSA-AES128-SHA:ECDHE-RSA-AES128-SHA:ECDHE-RSA-AES256-SHA:AES128-GCM-SHA256:AES256-GCM-SHA384:AES128-SHA:AES256-SHA
Signature Algorithms: ECDSA+SHA256:ECDSA+SHA384:ECDSA+SHA512:RSA-PSS+SHA256:RSA-PSS+SHA384:RSA-PSS+SHA512:RSA+SHA256:RSA+SHA384:RSA+SHA512:ECDSA+SHA1:RSA+SHA1
Shared Signature Algorithms: ECDSA+SHA256:ECDSA+SHA384:ECDSA+SHA512:RSA-PSS+SHA256:RSA-PSS+SHA384:RSA-PSS+SHA512:RSA+SHA256:RSA+SHA384:RSA+SHA512
Supported groups: X25519MLKEM768:x25519:secp256r1:secp384r1:secp521r1:ffdhe2048:ffdhe3072
Shared groups: X25519MLKEM768
CIPHER is TLS_AES_128_GCM_SHA256
À noter que si on avait lancé le serveur avec -groups
MLKEM768, Firefox ne pouvait se connecter (no
suitable key share) puisqu'il ne gère pas ML-KEM seul,
uniquement dans un contexte hybride (ML-KEM et ECDH-X25519). L'usage
de ML-KEM seul est décrit dans l'Internet
draft draft-ietf-tls-mlkem. Et
si vous voulez connaitre tous les mécanismes d'échange de clés de
votre installation d'OpenSSL :
% openssl list -kem-algorithms
  { 1.2.840.113549.1.1.1, 2.5.8.1.1, RSA, rsaEncryption } @ default
  { 1.2.840.10045.2.1, EC, id-ecPublicKey } @ default
  { 1.3.101.110, X25519 } @ default
  { 1.3.101.111, X448 } @ default
  { 2.16.840.1.101.3.4.4.1, id-alg-ml-kem-512, ML-KEM-512, MLKEM512 } @ default
  { 2.16.840.1.101.3.4.4.2, id-alg-ml-kem-768, ML-KEM-768, MLKEM768 } @ default
  { 2.16.840.1.101.3.4.4.3, id-alg-ml-kem-1024, ML-KEM-1024, MLKEM1024 } @ default
  X25519MLKEM768 @ default
  X448MLKEM1024 @ default
  SecP256r1MLKEM768 @ default
  SecP384r1MLKEM1024 @ default
(Pour ceux de signature, c'est openssl list
-signature-algorithms et, logiquement, on n'y trouve pas ML-KEM.)
Et dans curl ? Je n'ai pas testé mais normalement ceci marche :
curl -v --curves X25519MLKEM768 https://example.com
L'article seul
RFC 10023: The "_for-sale" Underscored and Globally Scoped DNS Node Name
Date de publication du RFC : Juillet 2026
Auteur(s) du RFC : M. Davids (SIDN Labs)
Pour information
Première rédaction de cet article le 31 juillet 2026
Vous vendez un ou plusieurs noms
de domaine ? Alors, marquez-les comme étant en vente, en
ajoutant le sous-domaine _for-sale, dont le
contenu permettra de donner des informations à d'éventuels
clients.
C'est une simple convention, qui ne modifie en rien le DNS et ne nécessite pas de changer les logiciels. Voici un exemple, avec un domaine de test :
% dig +short +nodnssec  _for-sale.example.nl. TXT
"v=FORSALE1;furi=https://example.nl/for-sale.txt"
"v=FORSALE1;ftxt=See the URL for important information!"
…
Il existe en effet toute une activité d'achat et de vente de noms de domaine. On la nomme en anglais domaining et ses pratiquants sont les domainers (parfois francisés en domaineurs). Quels que soient les sentiments que peuvent inspirer les pratiques, pas toujours très belles, de ces domaineurs, il faut noter qu'il s'agit d'une activité légale, explicitement prévue par de nombreux registres. Comment travaillent ces domaineurs ? Ils cherchent des noms « intéressants », regardent s'ils sont libres et les enregistrent, dans l'espoir de les revendre plus cher. Ou bien, s'ils ne sont pas libres, essaient parfois des les racheter à leurs titulaires, toujours dans l'espoir d'un bénéfice.
Comment savoir si un domaine est libre ? (Non, pas en faisant une
requête DNS ; un
nom peut être enregistré mais pas
publié dans le DNS.) Il existe des solutions normalisées
comme whois (RFC 3912)
ou RDAP (RFC 9083). Même si
le nom n'est pas libre, on
peut tenter de le racheter. Il existe des plate-formes de mise en contact de
vendeurs et d'acheteurs, comme par exemple
Sedo : 
(Sedo est juste un exemple ; il y en a d'autres, parfois gérés par des BE. Par exemple Afternic est propriété de GoDaddy. On trouve aussi des noms de domaine sur des plate-formes plus classiques par exemple en France Boischaut en vend sur InterEnchères. Attention, ces noms de plate-formes ne sont donnés qu'à titre d'exemple et ne sont certainement pas une recommandation. Une liste à jour de ces plate-formes est disponible.)
Mais il est préférable de pouvoir se passer
d'intermédiaire. Notre nouveau RFC propose donc une solution sans
intermédiaire pour prévenir que le nom de domaine est en vente :
vous ajoutez un sous-domaine _for-sale à votre
domaine, qui indique explicitement que vous vendez ce nom. Pourquoi
le précéder d'un tiret bas ? Pour limiter les
risques de collision avec les autres noms enregistrés (RFC 8552). Quelles valeurs associer à ce nom ? Un
enregistrement de type TXT, qui va donner des détails sur ce que le
vendeur propose. Plus précisément (section 2 du RFC), vous devez
commencer chaque enregistrement par
v=FORSALE1;. Vous pouvez ensuite ajouter au
choix (un seul par enregistrement mais vous pouvez mettre plusieurs
enregistrements) des couples clé=valeur :
- Une référence pour vous, avec la clé
fcod, qui peut permettre d'indiquer un identificateur sur une plate-forme d'achat et vente. - Un texte libre, avec
ftxt. Il est fortement recommandé qu'il soit en UTF-8 (RFC 3629), même si la norme DNS ne l'impose pas. En prime, le RFC recommande d'utiliser le profil limité du RFC 5198 et celui du RFC 9839, section 4.3. - Un URI, pour aller chercher davantage
d'informations (clé
furi). Le RFC recommande de se limiter aux planshttp,https,mailtoettel. Et de ne pas suivre automatiquement ces liens, ils peuvent être malveillants (section 4). Demandez confirmation plutôt deux fois qu'une. - Le prix demandé, avec la clé
fval. La monnaie utilisée doit être indiquée en suivant la norme ISO 4217.
Les enregistrements TXT associés au nom
_for-sale qui ne commenceraient pas par
v=FORSALE1; peuvent être ignorés (mais ils
peuvent contenir des informations supplémentaires). Si aucun
enregistrement TXT de ce sous-domaine ne commence par
v=FORSALE1;, il faut ignorer ce nom, et ne pas
considérer que le domaine est réellement en vente (cela peut être
l'effet d'un joker DNS, regardez par exemple
unipol-tech.com, il n'est pas en vente mais il y a un
joker, vous verrez un TXT pour n'importe quel nom comme
_for-sale.unipol-tech.com, cf. section 3.1).
Vous avez des exemples dans le RFC, section 2 et annexe A mais, sinon,
regardons le domaine cours-dns.fr. Vous pouvez regarder
avec dig :
%  dig _for-sale.cours-dns.fr TXT


; <<>> DiG 9.18.39-0ubuntu0.24.04.2-Ubuntu <<>> _for-sale.cours-dns.fr TXT
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 50746
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 6, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;_for-sale.cours-dns.fr.	IN TXT

;; ANSWER SECTION:
_for-sale.cours-dns.fr.	300 IN TXT "Read RFC 10023 to learn more"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;furi=https://www.afnic.fr/en/products-and-services/training/"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;fcod=42"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;fval=BTC1000"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;ftxt=Make money fast / Soyez friqu\195\169 rapidement"
_for-sale.cours-dns.fr.	300 IN RRSIG TXT 15 3 300 (
				20260303165737 20260216165737 37133 cours-dns.fr.
				pxYB9Wxx95+vSgzM1A+HfKyelYeHaHnbq/OIiK5IDW4L
				oC9ir7wG4pb4ehjHg8mrBEHguxiyT9UIL7ROSU/BAQ== )

;; Query time: 10 msec
;; SERVER: 192.168.2.254#53(192.168.2.254) (UDP)
;; WHEN: Thu Feb 19 10:50:27 CET 2026
;; MSG SIZE  rcvd: 454
(Notez que dig n'affiche pas le texte UTF-8 correctement.) Ou bien, plus joli, avec le DNS Looking Glass (là, l'Unicode est bien affiché). Ou bien via le démonstrateur de SIDN Labs, qui permet d'afficher plus proprement (en néerlandais) ces informations.
Bon, si vous voulez la même chose avec un vrai domaine vraiment en vente :
% dig _for-sale.actuals.nl TXT

; <<>> DiG 9.20.18-1~deb13u1-Debian <<>> _for-sale.actuals.nl TXT
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 61541
;; flags: qr rd ra; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;_for-sale.actuals.nl.	IN TXT

;; ANSWER SECTION:
_for-sale.actuals.nl.	1800 IN	TXT "v=FORSALE1;fcod=NLFS-OTQ0NTY5Y2YtY2ExNS00YWM0LTljNTgtN2I2YmU3Mzc4Njg5"
_for-sale.actuals.nl.	1800 IN	TXT "v=FORSALE1;furi=https://api.nameshift.com/sidn?domain=actuals.nl"

;; Query time: 32 msec
;; SERVER: ::1#53(::1) (UDP)
;; WHEN: Thu Feb 19 10:57:33 CET 2026
;; MSG SIZE  rcvd: 208
Vous noterez que le fcod est reconnu par la
plate-forme du .nl et
l'URI donné vous y emmène directement. 
Question sémantique, le RFC note que le
_for-sale n'est pas une promesse : le titulaire
du domaine qui met ce sous-domaine ne s'engage pas à vendre, il a
parfaitement le droit de renoncer à l'opération. C'est d'autant plus
vrai que le _for-sale récupéré peut avoir été
supprimé mais que votre résolveur DNS
l'avait gardé en mémoire (la section 3.4 met en garde contre les
TTL trop longs, la FAQ suggère une
heure).
Autre point amusant : un sous-domaine
_for-sale peut apparaitre partout dans l'arbre
des noms de domaines, donc on pourrait voir
Verisign publier un
_for-sale.com si cette entreprise voulait
vendre .com 😃. Seul
.arpa est exclu par le RFC. (Et la racine ? Le
RFC n'en parle pas.)
La section 4, sur la sécurité, rappelle qu'il faut considérer que le contenu de ces enregistrements TXT n'est pas sûr : il peut y avoir du XSS ou des tentatives d'injection SQL par exemple. Si vous écrivez un programme qui analyse ces enregistrements, soyez très paranoïaque.
Il y a aussi un risque non technique, celui de malhonnêtes
publiant des enregistrements _for-sale
alléchants mais trompeurs (_for-sale.sex.com. TXT
"V=FORSALE1; ftxt=Make money fast!!! Only $100!") afin de
vous amener à visiter un site Web de publicité ou de
hameçonnage. Il ne faut surtout pas, par exemple, lancer
automatiquement un achat sur la base de ces enregistrements.
Et puis rappelez-vous que les informations dans le DNS sont publiques, et que n'importe qui peut donc savoir que vous voulez vendre (c'est bien le but, mais il faut se souvenir que tout le monde, pas juste les acheteurs potentiels sérieux, verra ces informations, et elles peuvent contenir des données que vous ne voudriez pas trop diffuser comme les noms et adresses des personnes à contacter).
Le principal registre
promoteur de cette technique est celui du
.nl. Son interface Web
permet de voir, lorsqu'on affiche des informations sur un domaine,
qu'il est en vente (regardez par exemple https://www.sidn.nl/en/whois?q=123huren.nl

Il y a une page
officielle du projet avec beaucoup d'information, d'outils et
de détails. (Voir aussi ce site.) Le code
source est disponible. Il y a même un
MCP ! (Je ne l'ai pas
testé.) Pour créer vos enregistrements, vous pouvez vous aider de
ce générateur. Il existe aussi un
vérificateur d'enregistrements (notez qu'il a été écrit en
partie par un LLM à qui on a fait lire le brouillon du
RFC). La zone testdns.nl a une incroyable
collection d'enregistrements _for-sale, pour
tester les outils. Et évidemment, vous avez un assistant IA.
Le composant _for-sale a été ajouté au registre
IANA des noms préfixés d'un trait bas, registre qui avait été
défini par le RFC 8552.
L'article seul
RFC 10008: The HTTP QUERY Method
Date de publication du RFC : Juin 2026
Auteur(s) du RFC : J. Reschke (greenbytes), J.M. Snell
(Cloudflare), M. Bishop (Akamai)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF httpbis
Première rédaction de cet article le 16 juin 2026
Ce n'est pas tous les jours qu'on normalise une nouvelle méthode HTTP. Bienvenue, donc, à QUERY, qui rejoint des méthodes bien plus anciennes comme GET et POST. QUERY peut être décrit comme « GET mais avec un corps dans la requête ». Comme GET, elle est idempotente et donc sûre à répéter.
L'idée est de pouvoir interroger, par exemple, un service de recherche (vous verrez un exemple plus loin sur mon blog). Sans QUERY, on envoyait quelque chose du genre :
GET /feed?q=foo&limit=10&sort=published HTTP/1.1
On est donc obligés de mettre les paramètres dans l'URL. Cela peut poser problème si les paramètres sont nombreux et de grande taille, cela oblige à les pourcent-encoder et cela peut poser des problèmes de vie privée (l'URL demandé a des chances d'être enregistré dans un journal).
Des gens utilisent donc POST pour une recherche, bien qu'il n'ait pas la bonne sémantique :
POST /feed HTTP/1.1

q=foo&limit=10&sort=published
Mais on ne voit plus que la requête est idempotente. Un navigateur Web n'osera pas la répéter ou bien demandera confirmation à l'utilisateur. Et on ne pourra pas facilement mémoriser le résultat (puisque le client ne sait pas si la requête n'a pas d'effets de bord). QUERY résout le problème :
QUERY /feed HTTP/1.1

q=foo&limit=10&sort=published
La méthode est idempotente, le résultat peut être mémorisé.
La section 2 du RFC décrit avec précision QUERY. À lire si vous écrivez des clients ou des serveurs qui l'utilisent. Par exemple, puisque QUERY, contrairement à GET, inclut un corps dans la requête, le client doit indiquer le type de média utilisé, et sans se tromper, sinon le serveur lui renverra un 400. (Et un 415 si le type est bien là mais que le serveur ne le connait pas.) Autre chose à noter : en cas de redirection, le client ne doit pas changer de méthode (alors qu'on pouvait changer un POST en GET si la redirection était faite avec 301 ou 302). Autrement, QUERY ressemble beaucoup dans son comportement à GET. QUERY est désormais enregistré dans le registre des méthodes HTTP.
Un serveur HTTP qui met en œuvre QUERY n'accepte pas forcément
n'importe quel format en entrée. Pour documenter ce qu'il accepte
comme corps de la requête, notre RFC introduit un nouveau
champ HTTP, Accept-Query: (section 3)
qui est la liste des types de média
acceptés.
Vous avez plein d'exemples de requêtes et de réponses dans l'annexe A.
Il y a une mise en œuvre de QUERY sur ce blog, pour fournir un
moteur de recherche des
articles. L'URL est
https://www.bortzmeyer.org/methodquery et voici
un exemple d'utilisation avec curl :
% curl --request QUERY --data query=framasoft https://www.bortzmeyer.org/methodquery

    Query of "framasoft" OK

    https://www.bortzmeyer.org/capitole-du-libre-2023.html "Capitole du Libre 2023, et mon exposé sur la censure de l'Internet"
    …
Vous pouvez avoir une documentation plus détaillée de ce service
au début de son code source (en Python),
method-query.pytest-http-query.py
En parlant de curl, notez que, lorsqu'il suit
une redirection HTTP (option --location), il ne
transmet pas actuellement le
corps de la requête, ce qui casse ce service. Il faut de toute façon
utiliser
--follow.
La création de cette nouvelle méthode (ce qui est rare, je crois que la précédente avait été PATCH dans le RFC 5789 il y a quinze ans) a pris du temps. Le premier projet avait été rédigé en 2015 et le travail a connu plusieurs interruptions. Une des discussions avait porté sur le nom de la méthode, qui aurait pu s'appeler SEARCH (réutilisant une méthode normalisée dans le RFC 5323). L'annexe B du RFC discute le choix qui a été fait.
Une autre discussion portait sur le code de retour HTTP, un problème classique de tous les services tournant sur HTTP : si la requête est bien transmise et traitée mais qu'on n'a pas de résultat, doit-on quand même renvoyer le 200, qui signifie que tout s'est bien passé ? Avec GET, on utilise souvent 404 dans ce cas, mais c'est parce que le terme de recherche est dans l'URL, ce qui n'est plus le cas ici. On aurait pu aussi avoir un nouveau code commençant par 2. Finalement, le choix a été de renvoyer 200 quand la requête est bien arrivée et que le moteur de recherche a fonctionné, même s'il n'a rien trouvé. (Une discussion analogue avait eu lieu pendant le développement de DoH. Le RFC 8484 avait finalement décidé de répondre 200 même si le nom de domaine demandé n'existait pas.)
Ah, et si vous voulez superviser votre service HTTP utilisant QUERY, le programme check_http des monitoring plugins le permet. Voici un exemple de configuration pour Icinga :
vars.http_vhosts["query"] = {
    http_uri = "/methodquery"
    http_vhost = "www.bortzmeyer.org"
    http_ssl = true
    http_sni = true
    http_method = "QUERY"
    # Notez que le nom de la variable n'est pas très heureux.
    http_post = "query=foobar"
    http_content_type = "application/x-www-form-urlencoded"
    http_string = "foobar\" OK"
    http_timeout = 15
}
Sinon, si vous voulez d'autres lectures, il y a un bon article de Tykok.
L'article seul
RFC 10001: Operational Guidelines for DNS Transport in Mixed IPv4/IPv6 Environments
Date de publication du RFC : Août 2026
Auteur(s) du RFC : Momoka (WIDE Project), T. Fiebig (MPI-INF)
Réalisé dans le cadre du groupe de travail IETF dnsop
Première rédaction de cet article le 31 août 2026
Vous gérez des serveurs DNS (qu'ils soient des résolveurs ou des serveurs faisant autorité) dans un environnement où il y a à la fois IPv4 et IPv6 ? Alors, ce RFC va vous aider. Il remplace le RFC 3901, qui avait été écrit pour un monde très différent, où IPv6 était marginal. Désormais, la recommandation est que tout serveur DNS doit pouvoir servir les requêtes avec les deux versions d'IP.
Alors que le plan de transition initial pariait sur une migration de quelques années suite à laquelle IPv4 ne serait plus qu'un souvenir, la réalité est celle d'une co-existence de longue durée des deux versions (cf. RFC 9386). Le retard avec lequel certains acteurs de l'Internet ont migré fait que le paysage d'aujourd'hui est très complexe, avec des réseaux purement IPv4, des réseaux purement IPv6 et des réseaux mixtes. Si une zone DNS n'est servie que par des serveurs en IPv6, un résolveur n'ayant qu'IPv4 ne pourra pas la résoudre, et c'est pareil en sens inverse. On aurait une fragmentation de l'espace des noms de domaine, et c'est ce qu'il faut éviter. (Du fait du caractère arborescent du DNS, la fragmentation pourrait aussi se produire si un domaine parent, quelque part entre la racine et le domaine que vous voulez résoudre, n'avait qu'IPv4 ou qu'IPv6. Le RFC cite un cas encore plus amusant où, dans la chaine des noms, certains domaines ne sont accessibles qu'en IPv4 et d'autres qu'en IPv6 ; seul un résolveur à double pile - IPv4 et IPv6 - pourrait résoudre les noms situés au bout de cette chaine.) La lecture de « How Ready is DNS for an IPv6-Only World? » est recommandée.
Lorsque le RFC 3901, premier RFC à parler de la version d'IP utilisée pour transporter les requêtes et les réponses DNS, a été écrit, le paysage était nettement dominé par IPv4. Ce RFC 3901 se préoccupait surtout de maintenir la résolution de noms avec les zones existantes, dont l'écrasante majorité n'était servie qu'en IPv4. Aujourd'hui (voyez le rapport ARCEP), IPv6 est dans une position très différente, dans certains pays, la grande majorité des réseaux d'accès fournit IPv6, et les gros services Web populaires ont souvent IPv6. Bien des réseaux sont purement IPv6 à la base, IPv4 étant désormais un service fourni au-dessus d'IPv6. Le RFC 6540 considère à juste titre que IP, aujourd'hui, implique IPv6. Notre RFC remplace donc le RFC 3901 pour demander de l'IPv6 sur tous les serveurs faisant autorité et tous les résolveurs.
Un petit rappel au passage : ce RFC parle du transport des données dans les requêtes et les réponses DNS, pas des données elles-mêmes. Une requête/réponse pour des données de type A (adresses IPv4) peut se faire sur des messages échangés sur IPv6 et une requête/réponse pour des données de type AAAA (adresses IPv6) peut se faire sur des messages échangés sur IPv4.
Donc, il faut IPv4 et IPv6 sur les serveurs. Mais il ne suffit pas de croire qu'on a activé les deux. Des erreurs de configuration peuvent faire qu'on pense avoir IPv4 et IPv6 mais qu'un des deux ne marche pas. Cela peut être dû à un pare-feu qu'on a mis devant le serveur DNS (une mauvaise idée, en général, mais c'est une autre histoire) et qui n'autorise qu'une des deux versions. Mais il peut aussi y avoir des erreurs spécifiquement DNS :
- Les serveurs faisant autorité ont IPv4 mais pas d'enregistrements de type A (ou bien ils ont IPv6 mais on a oublié de publier un AAAA),
- les serveurs ont bien les enregistrements A et AAAA dans leur zone mais on a oublié la colle (RFC 9471),
- il y a la colle mais pas d'enregistrements dans la zone, ce
qui empêcherait les résolveurs qui revalident (cf.
draft-ietf-dnsop-ns-revalidation) de résoudre le nom, - le nom du serveur de noms est dans une autre zone, qui n'est pas elle-même résolvable en IPv4 et IPv6,
- une des zones situées au-dessus, dans l'arbre du DNS, n'est pas résolvable avec les deux versions d'IP (la résolution DNS part de la racine et suit un chemin descendant dans l'arbre des noms de domaine).
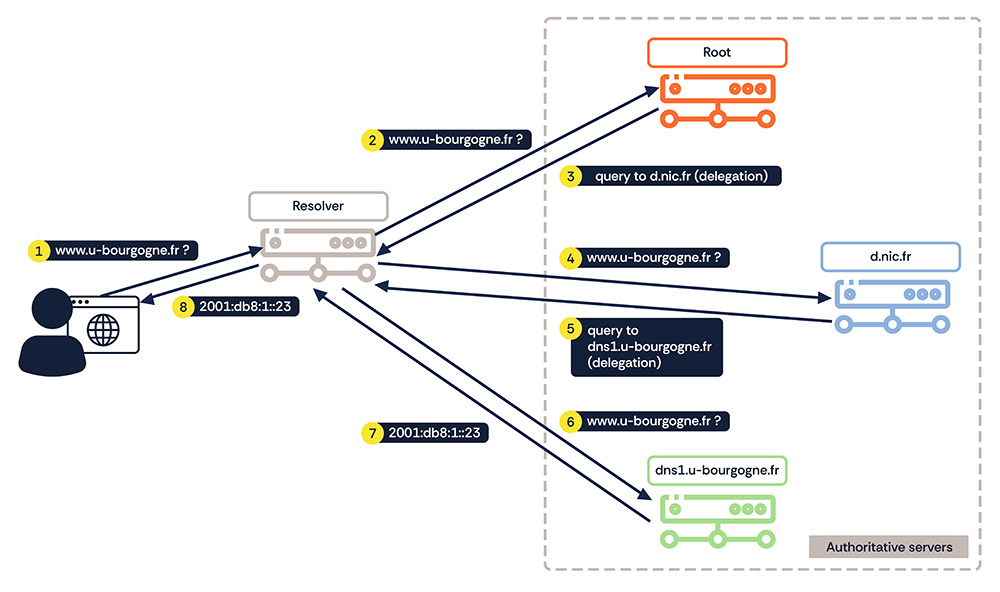
Toutes ces erreurs possibles imposent à l'administrateurice DNS de vérifier sa zone. On ne doit pas se contenter de se dire « c'est bon, j'ai tout configuré, on doit tester, par exemple avec Zonemaster (ou, en plus léger et moins riche, check-soa). Et re-tester régulièrement car des erreurs peuvent survenir par la suite.
% check-soa bortzmeyer.org
ns-global.kjsl.com.
	23.128.97.53: OK: 2026083000
	2607:7c80:53::53: OK: 2026083000
ns.eu.org.
	78.194.169.74: OK: 2026083000
ns1.bortzmeyer.org.
	80.77.95.49: OK: 2026083000
	2602:fbb1:1:245b::42: OK: 2026083000
ns1.shaftinc.fr.
	2001:41d0:404:200::49e1: OK: 2026083000
	51.178.53.118: OK: 2026083000
ns2.bortzmeyer.org.
	2400:8902::f03c:91ff:fe69:60d3: OK: 2026083000
	172.104.125.43: OK: 2026083000
ns2.shaftinc.fr.
	2a05:f480:1c00:28a:5400:2ff:fee7:316f: OK: 2026083000
	136.244.112.196: OK: 2026083000
ns4.bortzmeyer.org.
	2001:4b98:dc0:41:216:3eff:fe27:3d3f: OK: 2026083000
	92.243.4.211: OK: 2026083000
Il peut aussi y avoir des problèmes dûs au réseau. L'un des plus
courants est un problème de MTU. Si la réponse, notamment en raison des
signatures DNSSEC, dépasse la MTU du chemin, elle devra
être fragmentée et, dans l'Internet tel qu'il
est, cela se passera souvent mal (cf. RFC 8900
et RFC 9715). Il vaut mieux, pour un serveur
DNS, éviter d'envoyer des réponses trop grosses (le RFC suggère
1 232 octets maximum), pour être sûr qu'il n'y ait pas de
fragmentation. (Attention, le mot « fragmentation » ici n'a pas le
même sens que plus haut, quand on parlait de fragmentation de
l'espace de noms.) Notez que DNSSEC n'est pas nécessaire pour faire
des grosses réponses. Essayez oracle.com/TXT
pour voir.
Ça, c'était pour UDP. Et pour TCP ? Bien sûr, la découverte de la MTU du chemin existe (RFC 8201, RFC 8899) mais elle prend du temps alors que le DNS est censé avoir une très faible latence. Le RFC recommande donc de configurer la MSS à moins de 1 388 octets.
Mais il n'y a pas que la MTU. Par exemple, un résolveur peut avoir des problèmes de connectivité. Un cas où elle sera interrompue de manière intermittente (et donc difficile à déboguer) est celui où le résolveur est derrière un routeur CGNAT (RFC 6888) avec des délais d'expiration des « connexions » très court. Le trafic DNS, plutôt variable, ne sera pas suffisant pour maintenir la « connexion » ouverte. Et le RFC cite de nombreux autres exemples de problèmes réseau possibles.
Il est aussi possible qu'un serveur ne soit pas accessible avec une des deux versions d'IP suite à un choix délibéré. Si on regarde le domaine de la BNF, par exemple :
% check-soa bnf.fr
ariane.bnf.fr.
	193.50.133.237: OK: 2026081807
galatee.bnf.fr.
	193.50.133.202: OK: 2026081807
Pas d'IPv6 du tout. Comme le FAI de la BNF route l'IPv6, c'est certainement
un choix délibéré. En 2023 (étude « How
Ready is DNS for an IPv6-Only World? »), presque
aucun domaine n'avait que IPv6 alors que presque la moitié de ceux
testés n'avait que IPv4 (comme bnf.fr).
Après ces observations et analyses, le RFC, dans sa section 4, en arrive aux recommandations. Pour les serveurs faisant autorité, il faut, notamment :
- La règle « au moins deux serveurs faisant autorité par zone » devrait désormais être entendue comme « au moins deux en IPv4 et deux en IPv6 ». (On notera que cela ne figure pas dans les recommandations IANA, cf. section 6 du RFC.) Zonemaster fait déjà ce test (« Les serveurs de noms de la zone ne retournent pas assez de serveurs (1) faisant autorité ayant une adresse IPv6. La limite inférieure étant fixée à 2. »).
- Évidemment, ces (au moins) deux serveurs IPv6 ne doivent pas utiliser des adresses IPv6 spéciales, genre IPv4-embedded (RFC 6052), et la résolution de leurs noms ne doit pas nécessiter IPv4.
- Toujours aussi évidemment, les serveurs faisant autorité doivent servir les mêmes données en IPv4 et IPv6.
- Et pour être sûr de pouvoir passer des données de grande taille, sans compter sur la fragmentation, tous les serveurs doivent accepter TCP (RFC 9210).
Pour les résolveurs :
- Dans presque tous les cas, le résolveur devrait pouvoir parler IPv4 et IPv6.
- Si le résolveur n'a qu'IPv6 (ce qui sera de plus en plus fréquent), il faut qu'il puisse utiliser un mécanisme de coexistence qui lui permette de résoudre des zones purement IPv4 (par exemple RFC 6146, peut-être avec RFC 8781, ou bien en étant capable de faire suivre à un autre résolveur ayant tout ce qu'il faut).
- Pour les résolveurs simplifiés (stub
resolvers), comme celui dans la
libc, il faut s'assurer que les résolveurs
complets à qui ils transmettent leurs requêtes savent faire IPv4
et IPv6 (en indiquer plusieurs, par exemple dans
/etc/resolv.confsur Unix, ne marche pas bien, en raison de la limite sur leur nombre mais aussi du retard que cela entraine).
Le RFC ne semble pas en parler mais je tiens à ajouter une de mes obsessions personnelles : il faut superviser automatiquement vos serveurs DNS, en IPv4 et IPv6. Voici par exemple la configuration que j'utilise avec Icinga :
apply Service "dns-auth4" {
  check_command = "dig"
  assign where host.address && host.vars.dns_auth
  vars.dig_server = host.address
  vars.dig_ipv4 = true
  …
}

apply Service "dns-auth6" {
  check_command = "dig"
  assign where host.address6 && host.vars.dns_auth
  vars.dig_server = host.address6
  vars.dig_ipv6 = true
  …
}

object Host "mononoke" {
  address = "mononoke.bortzmeyer.org"
  address6 = "mononoke.bortzmeyer.org"
  vars.dns_auth = 1
  …
}
Et le serveur DNS sera alors testé avec les deux versions d'IP.
L'annexe A du RFC résume les changements depuis le RFC 3901 :
- Longue discussion sur la question de la fragmentation,
- Et surtout recommandation d'avoir les deux versions d'IP partout (et de le tester).
L'article seul
RFC des différentes séries : 0 1000 10000 2000 3000 4000 5000 6000 7000 8000 9000