Ce blog n'a d'autre prétention que de me permettre de mettre à la disposition de tous des petits textes que j'écris. On y parle surtout d'informatique mais d'autres sujets apparaissent parfois.
C'était mieux avant
Première rédaction de cet article le 8 novembre 2026
Les publications expliquant que l'Internet est foutu, que tout était mieux avant, abondent. Dans un article de la revue « Internet Histories », Kieran Hegarty se demande quand cette tendance est apparue et quelles sont ses caractéristiques.
Dans on article « When did the internet become this awful? », l'auteur appelle ces publications des IDN, les « Internet Decline Narratives ». Ces IDN sont très favorisés par les médias traditionnels, qui n'ont jamais pardonné à l'Internet d'avoir écorné leur monopole de la parole, et aussi par les politiciens qui aiment bien présenter l'Internet comme essentiellement négatif, ce qui leur permet de promouvoir ensuite contrôle et interdiction.
Ces IDN ne sont pas, en général, une critique argumentée du numérique. La critique est tournée vers le futur, vers ce qu'il faudrait changer. Au contraire, les IDN parlent du passé, un passé en général mythifié. Ils fixent de manière assez arbitraire une date à partir de laquelle les choses n'ont fait qu'aller mal (le septembre éternel ? Le Web ? L'IA générative ?).
Kieran Hegarty n'en parle pas beaucoup mais je note que ce discours « IDN », qui suppose qu'il y a eu un Internet parfait à une époque, rencontre souvent un discours réactionnaire qui estime que l'Internet, voire le numérique, a toujours été mauvais. Les IDN s'inscrivent dans la longue histoire des paniques morales qui avaient accompagné tous les nouveaux outils de communication à leurs débuts.
Et ces IDN ont des faiblesses : d'abord, ils invisibilisent complètement les utilisateurices, les réduisant au statut de victimes passives. Alors que ces utilisateurices agissent, choisissent, et ne suivent pas aveuglément (pour le cas des enfants, cf. par exemple les livres d'Anne Cordier, plutôt que les textes réactionnaires qui traitent ouvertement les utilisateurices de crétins). Oublier ces humain·es tend à écarter toute réflexion sur comment on pourrait améliorer les choses. D'accord, les utilisateurices manquent de culture numérique, et peuvent être trompés, et le sont souvent. Mais cela ne les réduit pas à de simples poupées qui feraient exactement ce que les GAFA prévoient pour eux.
Ensuite, les IDN ignorent la variété des usages de l'Internet. Politiciens et journalistes qui parlent de l'« Internet » ne connaissent en général que deux ou trois réseaux sociaux capitalistes et basent tout leur discours sur ces services, qui sont loin d'être la totalité des usages du Web, sans même parler de l'Internet en général.
Enfin, ces IDN sont souvent occidentalo-centrés, faisant comme si les usages et les phénomènes constatés dans le pays de l'auteur de l'IDN était universel. L'Internet est divers, et ses utilisateurices aussi. La technostalgie est parfois une nostalgie d'un monde passé où l'accès à l'Internet était limité à une population très homogène…
Au sujet de cet occidentalo-centrisme, l'auteur de l'article cite Payal Arora, la référence classique des tenants d'un discours techno-optimiste, s'appuyant sur un point de vue « du Sud ». Mais je trouve qu'Arora, citée ici de manière acritique, a aussi ses limites, notamment en allant franchement du côté de l'optimisme béat ; or, ce n'est pas parce qu'un paysan indien a un smartphone et est connecté qu'il devient libre et enpouvoiré. Son vécu demeure très influencé par des organisations puissantes sur lesquelles il n'a pas complètement prise.
Je rajoute aux remarques d'Hegarty que les IDN présentent souvent l'Internet comme un acteur en soi, ayant ses propres objectifs et sa propre dynamique, ce qui conduit à oublier qu'il y a des humains derrière, qui sont à l'origine des décisions. Ce n'est pas « l'Internet » qui capture des données en masse, ce sont Meta, Alphabet et les autres. Et ces entreprises ne font pas cela en raison d'idées transhumanistes fumeuses (contrairement à ce que racontent les intellectuells français, qui aiment bien se mettre dans la posture de défenseurs de l'humanité), mais parce que ce sont des entreprises capitalistes, que leurs dirigeants pilotent en fonction du profit.
Tout cela ne doit pas conduire à ignorer les critiques, qui sont parfaitement légitimes, et en général justifiées, quand on dit du mal des GAFA. Mais il faut faire attention à ne pas les inscrire dans une démarche de déclin obligatoire et inévitable.
L'article seul
RFC 10073: Composite Module-Lattice-Based Digital Signature Algorithm (ML-DSA) for use in X.509 Public Key Infrastructure
Date de publication du RFC : Novembre 2026
Auteur(s) du RFC : M. Ounsworth, J. Gray (Entrust), M. Pala (OpenCA Labs), J. Klaussner (Bundesdruckerei), S. Fluhrer (Cisco Systems)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF lamps
Première rédaction de cet article le 7 novembre 2026
C'est bien joli d'utiliser des algorithmes post-quantiques pour que ses signatures ne soient pas attaquées par les futurs calculateurs quantiques. Mais si l'algorithme post-quantique cède devant une attaque cryptanalytique classique, n'aura t-on pas échangé la proie pour l'ombre ? La solution hybride est de mettre dans ses certificats X.509 deux clés et deux signatures, traditionnelle et post-quantique, et d'exiger que les deux signatures soient valides.
Ce RFC normalise donc les clés et signatures pour une configuration hybride, un algorithme traditionnel, qui peut être RSA, ECDSA ou EdDSA, et un algorithme post-quantique, actuellement uniquement ML-DSA. Le RFC utilise le terme de composé plutôt qu'hybride pour insister sur le fait que les deux algorithmes sont toujours utilisés ensemble.
Si vous voulez un arrière-plan sur ce post-quantique et ses motivations, voyez le RFC 9958. Tout le projet de transition vers le post-quantique est soumis à deux incertitudes, la date à laquelle on aura des CRQC (Cryptographically Relevant Quantum Computers) et la sécurité des algorithmes post-quantiques, plus récents et moins testés. N'utiliser que l'algorithme traditionnel est imprudent, car des CRQC pourraient arriver un jour, n'utiliser que l'algorithme post-quantique est imprudent car on ne peut pas encore être parfaitement sûr de sa sécurité, à la fois face à la cryptanalyse, et face à une éventuelle erreur de programmation. D'où l'hybride, tel que décrit dans le RFC 9794. Certaines régulations, par exemple en France ou en Allemagne exigent ces systèmes hybrides.
Notre RFC 10073 pousse le concept d'hybride un peu plus loin avec un système composé, c'est-à-dire que les deux clés et les deux signatures seront toujours vues comme une (RFC 9794, section 2). Cela permet l'utilisation dans des protocoles qui ne connaissent pas le concept d'hybride et qui ne s'attendent pas à devoir faire deux vérifications. (L'idée originelle vient de cet article, ce qui n'a pas empêché des brevets comme US20220353061A1 ou US11968316B1 d'être déposés après.) Et les composés ont aussi l'avantage de moins changer les logiciels, facilitant une éventuelle re-certification.
Donc, résumons : ce RFC normalise un schéma hybride de signature qui inclus un algorithme post-quantique, ML-DSA (normalisé dans FIPS 204 et aussi un peu dans le RFC 9881), avec, au choix, RSA tel que décrit dans le RFC 8017, ECDSA tel que normalisé dans FIPS 186.5 ou encore Ed25519 (voir le RFC 8410). Les signatures, pour ce RFC, sont toujours combinées en une seule. Une vérification réussie implique que les deux signatures soient valides.
Je ne vais pas reprendre les parties purement cryptographiques du RFC (trop dur pour moi), regardez par exemple la section 4 si vous voulez voir l'encodage exact des clés et signatures. Point amusant : on met toujours clé et signature ML-DSA en premier car, contrairement à RSA, leurs tailles sont fixes et cette règle permet donc facilement de retrouver les deux clés ou les deux signatures. (Sinon, l'annexe A détaille les tailles de différents objets, vous y verrez que l'augmentation de taille due à l'utilisation d'une clé ou d'une signature composées est négligeable par rapport à ML-DSA seul.)
Le but de ce RFC est l'utilisation de ce schéma composé dans
X.509/PKIX donc la
section 5 décrit comment représenter clés et signatures dans un
certificat. (Notez que le cas de CMS est repoussé à
une future norme.) Comme ML-DSA ne permet que la signature, pas le
chiffrement, le certificat peut avoir les utilisations
digitalSignature ou
keyCertSign mais pas
keyEncipherment ou
encipherOnly (même si le composant traditionnel
l'aurait permis ; rappelez-vous qu'un schéma composé doit utiliser
les deux algorithmes, le post-quantique et le traditionnel, sinon il
ne fournit pas la sécurité attendue). Des identifiants sont réservés
pour toutes les variantes possibles, par exemple
id-MLDSA65-Ed25519-SHA512 identifie un composé
ML-DSA 65 avec Ed25519. Le module ASN.1
complet est en section 7 du RFC, avec, pour reprendre cet exemple :
 id-MLDSA65-Ed25519-SHA512 OBJECT IDENTIFIER ::= {
      iso(1) identified-organization(3) dod(6) internet(1) security(5)
      mechanisms(5) pkix(7) alg(6) 48 }
Et comme la sécurité est compliquée, la section 9 précise un certain nombre de points pour faire proprement du composé avec ML-DSA. Elle rappelle qu'un schéma hybride de cryptographie peut servir à augmenter la sécurité (imposant à un attaquant de devoir casser l'algorithme post-quantique et le traditionnel) ou bien à permettre une transition en douceur au fur et à mesure de la disponibilité de logiciel qui connait la cryptographie post-quantique. Dans le premier cas, celui de notre RFC, on impose que les deux signatures soient valides. Dans le second, qui n'est pas le choix du RFC, qu'une seule le soit. (Je crois me souvenir qu'au début de ce RFC, le projet était d'avoir les deux possibilités. Quelqu'un a mieux suivi les débats que moi ?)
Certains experts n'aiment pas l'idée de l'hybride en disant que, si un attaquant ne sait attaquer qu'un seul des deux algorithmes, il ne va pas s'embêter, il va simplement génerer un faux document avec une seule signature, celle de l'algorithme qu'il sait casser. La réponse à cet argument est que le vérificateur choisit sa politique : il peut décider de n'accepter que les hybrides.
Si vous voulez une analyse de sécurité plus détaillée, avec notamment la prise en compte des modèles de menace EUF-CMA et SUF-CMA, elle se trouve en section 9.2 (les systèmes décrits dans ce RFC résistent face à EUF-CMA mais pas face à SUF-DMA).
Autre question amusante (section 9.5), que se passe t-il lorsqu'un algorithme utilisé dans l'hybride est considéré comme dépassé ? Avec les systèmes à un seul algorithme, c'est clair : si on connait (ou soupçonne sérieusement) une attaque faisable contre l'algorithme, on arrête de l'utiliser. Mais avec un hybride, c'est plus compliqué de décider puisque, après tout, le deuxième algorithme tient toujours. Cela peut compliquer, par exemple, les analyses de sécurité puisqu'un audit trop sommaire verra l'algorithme vulnérable, sans tenir compte du fait qu'il n'est utilisé qu'au sein d'un système hybride.
La section 10 du RFC se penche ensuite sur quelques problèmes concrets. Par exemple, le bon sens nous dit que, dans un système hybride, il faut que les deux composants, le post-quantique et le traditionnel, aient à peu près la même « force », le même niveau de sécurité, sinon, le plus faible n'apportera pas grand'chose. Mais on ne sait pas quantifier cette « force » entre deux algorithmes aussi différents que, par exemple, ML-DSA et Ed25519. Et d'autant plus que ML-DSA, plus récent, est moins étudié ou testé « au feu ». Donc, le RFC ne prétend pas que tous les hybrides normalisés soient « équilibrés ». Le choix des combinaisons a plutôt été fait sur la base du réalisme (algorithmes courants). Lors de la discussion à l'IETF, plusieurs personnes ont estimé que ce RFC créait trop de composés et qu'il aurait fallu réduire le choix à quelques combinaisons bien choisies, mais le groupe de travail a finalement décidé de « donner » à chacun sa combinaison favorite.
Sinon, vous savez que les décideurs, en matière de sécurité, se
préoccupent souvent davantage de conformité que de sécurité. Il y a
des régulations diverses et il est plus important de les respecter
que de choisir le « meilleur » système. La section 10.2 vient à leur
aide en expliquant comment utiliser les systèmes composés de ce RFC
si on doit respecter FIPS. Si un seul des deux algorithmes du
composé est conforme à FIPS, il faudra présenter le système comme
ayant la sécurité de ce composant, pas celle du composé complet. Si
on n'a pas ce problème de conformité, et qu'on n'est pas expert en
cryptographie soi-même, le composé recommandé par ce RFC est
id-MLDSA65-ECDSA-P256-SHA512.
Enfin, l'annexe E contient les vecteurs de test, qui forment, en nombre de pages, la grande majorité du RFC. Plutôt que d'essayer de les extraire laborieusement du RFC, il vaut mieux aller les chercher en ligne.
L'article seul
RFC 10080: Updated Use of the Expires Message Header Field
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : B. Billon (Splio), J. Levine
(Standcore)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF mailmaint
Première rédaction de cet article le 31 octobre 2026
Ce RFC
normalise le champ Expires: dans l'en-tête d'un
message. Il
existait déjà mais n'avait apparemment jamais été spécifié
officiellement. Il indique quand un message cesse d'être
utile et n'a plus besoin d'être montré.
L'utilisation envisagée est que le MUA peut déclasser un message expiré, voire le masquer complètement (le détruire n'est pas recommandé, un message expiré n'est plus valide mais peut garder, par exemple, un intérêt historique). Notre RFC n'essaie pas de donner une signification trop précise à ce champ, encore moins de requérir des actions spécifiques par le logiciel.
Donc, le champ garde sa syntaxe (section 3), la forme de la date-et-heure étant tirée du RFC 5322, section 3.3 :
Expires: Thu, 16 Jul 2026 11:28:03 +0000
(Si vous utilisez le logiciel GNU date, l'option
--rfc-email permet d'afficher une date-et-heure
au bon format.)
On l'a dit, ce RFC n'est pas trop normatif, mais il donne quand
même des avis. La section 4 conseille aux logiciels de création de
messages de mettre un Expires: quand on sait
que le message perdra son intérêt après un certain moment. C'est par
exemple le cas d'une promotion commerciale qui a une date de fin,
d'un message qui annonce un évènement ou d'un message périodique,
qui n'est valable que jusqu'à l'émission du suivant.
La section 5, elle, consacrée aux logiciels de lecture, leur
suggère de diminuer la priorité d'affichage des messages expirés,
voire de ne pas les montrer du tout. Elle estime qu'il ne faut pas
refuser un message uniquement sur la base du champ
Expires:, et ne pas, par défaut, détruire les
messages expirés (mais on peut avoir une option du logiciel pour
activer cette destruction).
On notera qu'il existe un projet Email Expiration
Date pour développer l'utilisation du champ
Expires:. Ce projet, porté par plusieurs
acteurs spécialisés dans l'envoi massif de messages, a développé
un
greffon Thunderbird mettant en œuvre l'expiration des
messages. Jusqu'à présent, je n'ai vu ce champ dans des vrais
messages que dans les spams de la SNCF, par
exemple un message expédié en juin qui indiquait Expires:
Monday, 21 December 2026 14:38:28 +0000 (cette date était
sans rapport avec le contenu de la publicité, mais était à six mois
dans le futur donc je suppose qu'un Expires:
d'une demi-année est mis automatiquement).
Ce champ Expires: a une histoire. Le RFC 1327 décrit déjà, dans le contexte de
l'interopérabilité avec X.400, un champ
Expiry-date:. Le RFC 2156 le renomme Expires:, en
indiquant juste sa syntaxe (une date-et-heure, au format du - à
l'époque - RFC 822) et peu de sémantique à
part qu'on ne pouvait pas compter que ce champ soit appliqué
automatiquement. Puis le RFC 4021 l'a placé
dans le
registre de l'en-tête du courrier. Notez qu'un autre format,
celui des News, a un champ
Expires: (RFC 5536,
section 3.2.5), avec une syntaxe et une sémantique proche. Comme,
dans le contexte du courrier
électronique, ce champ existe depuis longtemps, mais
avec peu ou pas de spécification, il aurait été difficile de définir
une spécification stricte, cela aurait cassé certains usages
existants (cf. section 6).
L'article seul
Qu'est-ce qu'un « DNS menteur » ?
Première rédaction de cet article le 28 octobre 2026
Cet article explique le concept de « DNS menteur », terme souvent entendu, par exemple dans le contexte de la censure de l'Internet.
Si vous lisez souvent ce blog, vous n'apprendrez rien de nouveau ici. Le but de cet article est juste d'avoir une référence stable pour expliquer ce terme de « DNS menteur », sinon pour un large public, du moins pour une population plus large que les seuls experts DNS.
Donc, pour commencer, tout petit rappel sur le DNS (Domain Name
System) : le DNS permet de distribuer de l'information aux
machines connectées à l'Internet. (Les humain·es normaux ne
regardent en général pas cette information, qui est purement
technique.) La clé d'accès à cette information est un nom
de domaine comme www.bortzmeyer.org
ou phy.cam.ac.uk. Le point important est que
quasiment toute interaction sur l'Internet
commence par une utilisation du DNS, que votre machine fait pour
vous. Si le DNS est en panne, c'est quasiment comme si vous n'avez
plus d'Internet. Et, ce qui nous intéresse ici, si le DNS vous ment
sur les informations techniques récupérées, vous n'avez guère
d'autre choix que de le croire. (Avis aux expert·es : oui, je
simplifie. J'ai indiqué quelques ressources plus complètes à la fin
de cet article.)
Votre machine (ordinateur, ordiphone,
brosse à dents connectée) fait des requêtes DNS pour vous et elle
les fait à un serveur nommé résolveur
DNS. C'est une machine en général gérée par l'organisation
qui vous fournit l'accès à l'Internet. Normalement, en l'absence de
« DNS menteur », votre résolveur ne fabrique pas d'information, il
se contente de vous transmettre ce qu'il a appris d'une autre
famille de serveurs DNS, les serveurs faisant
autorité. Ceux-ci sont gérés par diverses organisations, par
exemple les serveurs faisant autorité pour
cnrs.fr sont gérés par le CNRS, alors que ceux faisant autorité pour
sephora.fr sont gérés par l'hébergeur
Akamai.
Donc, normalement, lorsque vous voulez envoyer du courrier à
QuelqUn@cnrs.fr, une machine va demander à un
résolveur DNS quel est le serveur de messagerie du CNRS et cette
réponse viendra des serveurs faisant autorité pour
cnrs.fr. Mais ça, c'est le comportement
normal. Or, puisque presque toute interaction sur l'Internet
commence par un appel au DNS, un certain nombre de gens se sont dit
qu'ils pouvaient utiliser ce qui était conçu comme un service
technique en outil de contrôle. Après tout, qui
contrôle le résolveur, contrôle la quasi-entièreté du vécu de
l'utilisateurice.
Un « DNS menteur » ou, plus rigoureusement, un « résolveur DNS menteur » est donc un résolveur qui, au lieu de relayer sincèrement les réponses des serveurs faisant autorité, invente des réponses, en général, dans le but de bloquer l'accès à un service Internet.
Notez bien que les résolveurs DNS menteurs ne sont pas tous pareils. Ils diffèrent par :
- La raison du mensonge : cela peut être la censure étatique, la censure au profit des ayants-droit, le blocage des publicités, le blocage de l'accès à des services malveillants, etc,
- la nature de l'entité qui décide : le résolveur menteur a pu être configuré pour mentir par l'utilisateurice, par quelqu'un agissant sur demande de l'utilisateurice ou par un tiers (par exemple dans le cas de la censure).
Vous noterez donc que « résolveur DNS menteur » est une simple description factuelle, les motivations et les acteurs étant variés. Des exemples d'utilisation pour la censure sont communs en Europe. Au moment de l'écriture de cet article, le gouvernement français a annoncé son intention de pouvoir bloquer les réseaux sociaux sur simple demande de sa part, et, si cela se fait, ce sera sans doute via des résolveurs DNS menteurs. (D'autres pays dans le monde utilisent d'autres techniques de censure de l'Internet.) Si vous voulez par contre un exemple dans le domaine du blocage de ces insupportables (et dangereuses) publicités , le système Pi-hole est un résolveur configuré pour mentir sur les noms de domaine utilisés par les services de publicité.
On fait souvent remarquer que, comme technique de censure, le résolveur DNS menteur n'est pas efficace car il est toujours possible de changer de résolveur. C'est techniquement exact mais il y a deux limites :
- L'opération est souvent plus complexe qu'il ne parait, par exemple certains FAI, comme Orange, ne permettent pas cette opération sur leur box. OK, on peut toujours y arriver mais tout le monde n'a pas forcément envie de se lancer dans ce genre de manipulations. (Si vous n'êtes pas technicien·ne et qu'un technicien prétentieux vous affirme que c'est trivial à faire, ne le croyez pas.)
- Et, surtout, il n'est pas normal que l'accès à l'information soit limité aux citoyen·nes qui ont la connaissance de la technique.
(Oui, je sais, on peut aussi utiliser un VPN.)
Le reste de cet article est consacré à un certain nombre de
détails, en général de nature technique.
D'abord, que se passe-t-il précisément quand un résolveur vous
ment. Essayons avec le domaine
tarjetarojatvlive.net. Ironiquement, le site
Web ne marche plus (il semble rediriger vers des choses assez
louches, ne l'essayez pas) mais, à une époque, une décision de
justice au profit des ayants-droit exigeait sa censure. Avec les
résolveurs de Free :
% dig @212.27.40.240 tarjetarojatvlive.net
…
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 35658
;; flags: qr rd ra; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 512
;; QUESTION SECTION:
;tarjetarojatvlive.net.	IN A

;; ANSWER SECTION:
tarjetarojatvlive.net.	600 IN A 127.0.0.1

;; Query time: 5 msec
;; SERVER: 212.27.40.240#53(212.27.40.240) (UDP)
;; WHEN: Wed Oct 28 16:26:09 CET 2026
;; MSG SIZE  rcvd: 66
La réponse est clairement mensongère, l'adresse 127.0.0.1 étant
l'adresse locale de la machine. (Les vraies adresses sont
172.104.149.86 et quelques autres.)
Ensuite, comment savoir si le résolveur que vous utilisez ment ? Une solution possible est évidemment de lire sa documentation mais, par exemple, en France, je ne connais aucun FAI qui documente les censures pratiquées. Il existe une solution technique pour que le résolveur indique qu'il a menti, les EDE (Extended DNS Error), normalisées dans le RFC 8914 mais, là encore, je ne connais pas de FAI français qui les utilise (comme vous le voyez dans la réponse de Free ci-dessus). Par contre, Google Public DNS le fait. Regardons avec dig :
% dig @8.8.8.8 tarjetarojatvlive.net
…
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: REFUSED, id: 65388
;; flags: qr rd ra; QUERY: 1, ANSWER: 0, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags:; udp: 512
; EDE: 16 (Censored): (The requested domain is subject to a judicial injunction or other governmental blocking order for FR (ISO country code). To learn more about this specific removal, please visit https://lumendatabase.org/notices/41939614.)
;; QUESTION SECTION:
;tarjetarojatvlive.net.	IN A

;; Query time: 6 msec
;; SERVER: 8.8.8.8#53(8.8.8.8) (UDP)
;; WHEN: Wed Oct 28 16:22:46 CET 2026
;; MSG SIZE  rcvd: 276
Il ne s'agit pas réellement d'un résolveur DNS menteur car Google a
été franc : le domaine est censuré (code EDE 16) et Google renvoie
même à la
page Lumen décrivant ce cas. Mais le résultat va être le même
pour l'utilisateurice, simplement plus clair. D'ailleurs, je ne sais
pas pourquoi Free, dans l'exemple plus haut, renvoie une adresse
bidon (le 127.0.0.1) au lieu d'un code REFUSED
(comme Google) ou à la rigueur NXDOMAIN (indiquant que le domaine
n'existe pas). Certains résolveurs DNS menteurs renvoient une
adresse IP qui est celle d'un serveur Web contenant des explications
mais c'est la pire solution de toutes, par exemple pour la vie privée.
La censure dépend évidemment du pays et, pour étudier la censure dans d'autres pays que le vôtre, vous pouvez utiliser, par exemple, les sondes RIPE Atlas (attention toutefois aux questions éthiques).
J'ai dit qu'on pouvait toujours (plus ou moins facilement) changer de résolveur. Je ne vais pas donner de liste de résolveurs, car, dès qu'ils sont largement utilisés, ils deviennent des cibles pour la censure. Il faut au contraire, dans ce cas comme dans beaucoup, plein de résolveurs un peu partout. (Et les résolveurs publics des GAFA sont évidemment à éviter.)
Et quelques lectures supplémentaires :
- Sur ce blog, le premier article que j'avais fait sur le sujet en 2009, un article plus détaillé sur le cas de la censure administrative française (ce n'est hélas pas un sujet nouveau), un autre exemple français, cette fois sur demande des ayants-droit, un article sur le fait qu'un résolveur qui refuse de mentir n'a parfois d'autre choix que d'arrêter de servir un pays, un exposé sur la difficulté du choix de la bonne solution de résolveur et un article sur la possibilité d'avoir son propre résolveur, qu'on contrôle.
- L'IETF a produit le RFC 7754 pour discuter du problème du blocage et du filtrage sur l'Internet (voir aussi le RFC 9707). Puisqu'on parle de l'IETF, notons que cette organisation a renoncé à normaliser le système RPZ qui sert à configurer certains résolveurs DNS menteurs.
- La question des résolveurs DNS menteurs est ancienne et le Conseil Scientifique de l'Afnic avait fait une excellente étude sur la question, en 2013.
- L'article de Wikipédia sur le sujet est médiocre et ancien. Si vous avez le courage de l'améliorer, vous pouvez copier-coller du contenu de cet article, les licences sont compatibles.
L'article seul
On peut générer de vrais/faux certificats
Première rédaction de cet article le 22 octobre 2026
Vous avez sans doute déjà lu des articles sur la faille de l'AC eMudhra (sinon, vous avez des liens à la fin). Une des conséquences de cette faille est que tout le monde peut générer des vrais/faux certificats. Exemple.
La faille (depuis éclipsée par deux grosses failles PHP) venait d'un générateur de nombres aléatoire trop faibles. Un certificat est une clé cryptographique publique signée par une AC. La clé privée correspondant à cette clé publique doit être choisie de manière à être imprévisible pour l'attaquant. (On dit souvent qu'elle doit être choisie aléatoirement ce qui, en pratique, est juste un peu plus fort que de dire « imprévisible ».) Mais un générateur imprévisible est difficile à faire sur une machine déterministe comme un ordinateur. Et les logiciels ont des bogues. Une bogue frappait apparemment l'AC eMudhra : les clés générées ne faisaient qu'un octet (le reste étant toujours nul), ce qui ne faisait que 256 clés possibles, rendant triviale une énumération de toutes les clés possibles. L'une d'elles était juste le chiffre 4, que vous trouverez souvent dans les articles sur cette faille.
Le fonctionnement du système X.509 étant ce qu'il est, si on peut générer les clés d'une AC qui est largement présente dans les magasins d'AC de plusieurs systèmes d'exploitation / logiciels / langages, on peut se faire passer pour n'importe qui.
Démonstration avec le service
emudhra.insecureoldshit.com:443. Il n'a pas de
lien avec l'AC eMudhra mais, comme n'importe qui peut générer les
clés « privées » d'eMudhra, il peut se faire passer pour elle. Ne
cherchez pas forcément à vous connecter en HTTPS, c'est
déjà intéressant avec juste du TLS nu. Essayons avec
GnuTLS :
% gnutls-cli  emudhra.insecureoldshit.com:443
Processed 152 CA certificate(s).
Resolving 'emudhra.insecureoldshit.com:443'...
Connecting to '2.29.115.248:443'...
- Certificate type: X.509
- Got a certificate list of 3 certificates.
- Certificate[0] info:
 - subject `CN=192.134.4.66:6621,OU=You,O=Penguin Association,C=AQ', issuer `CN=EM OV TLS CA - G3C,O=eMudhra Inc,C=US', serial 0x00, EC/ECDSA key 256 bits, signed using ECDSA-SHA384, activated `2026-10-22 12:35:47 UTC', expires `2026-10-22 12:36:17 UTC', pin-sha256="Ma4OU2jrnyfraVMqehw9AlMFRBOGdaRziAjvPGDwKKc="
	Public Key ID:
		sha1:779bc70e16304e65523397a5e1ccdc14cb673c39
		sha256:31ae0e5368eb9f27eb69532a7a1c3d02530544138675a4738808ef3c60f028a7
	Public Key PIN:
		pin-sha256:Ma4OU2jrnyfraVMqehw9AlMFRBOGdaRziAjvPGDwKKc=

- Certificate[1] info:
 - subject `CN=EM OV TLS CA - G3C,O=eMudhra Inc,C=US', issuer `CN=emSign Root TLS CA - G3,O=eMudhra Technologies Limited,C=IN', serial 0x296926c227a3a1526392b19482a504, EC/ECDSA key 384 bits, signed using ECDSA-SHA384, activated `2025-04-30 15:37:41 UTC', expires `2040-04-28 18:30:00 UTC', pin-sha256="Y+zv7kMdSVI7wRNsTnLQIGpHcIbK9gbNXPAlaGwQnPg="
- Certificate[2] info:
 - subject `CN=emSign Root TLS CA - G3,O=eMudhra Technologies Limited,C=IN', issuer `CN=emSign ECC Root CA - G3,O=eMudhra Technologies Limited,OU=emSign PKI,C=IN', serial 0x00961a3efb1359576ed04005b4684a5b, EC/ECDSA key 384 bits, signed using ECDSA-SHA384, activated `2024-07-11 15:43:36 UTC', expires `2039-07-09 18:30:00 UTC', pin-sha256="xhnkeA7Y4KvtokrXMlZ95Dg6fqlBM49tGn0bSax5L+k="
- Status: The certificate is trusted.
- Description: (TLS1.3-X.509)-(ECDHE-X25519)-(ECDSA-SECP256R1-SHA256)-(AES-128-GCM)
- Session ID: 8A:5F:E1:E3:6A:6D:00:01:5E:09:1E:78:5B:79:A8:BB:09:31:29:7F:9F:6B:C4:F3:6E:E0:72:F4:8E:45:7C:D2
- Options:
- Handshake was completed
Notons plusieurs choses :
- Le certificat du client (celui de numéro 0) a comme titulaire
(« subject »)
CN=192.134.4.66:6621,OU=You,O=Penguin
    Association,C=AQ
. À la syntaxe du RFC 4514 (qui normalise la forme texte du modèle de données de X.500), cela veut dire que le nom est192.134.4.66(l'adresse IP du client du service, ici moi), l'organisation est la fictive « Penguin Association » et le pays est l'Antarctique. (Rappelez-vous que c'est un vrai/faux certificat, généré lors de ma connexion.) - Le certificat final est signé par l'AC eMudhra (
CN=EM OV TLS CA - G3C,O=eMudhra Inc,C=US)… En fait, c'est une vraie/fausse signature, faite en récupérant une des clés privées de eMudhra, grâce à l'énumération des clés possibles. - Le certificat a été accepté sur cette machine (une Debian, où le certificat d'eMudhra était dans le magasin du système) : « The certificate is trusted. ».
Si maintenant je mets à jour mon système (les certificats des AC
sont dans le paquetage Debian ca-certificates) :
% gnutls-cli  emudhra.insecureoldshit.com:443
Processed 150 CA certificate(s).
Resolving 'emudhra.insecureoldshit.com:443'...
Connecting to '2.29.115.248:443'...
- Certificate type: X.509
- Got a certificate list of 3 certificates.
- Certificate[0] info:
 - subject `CN=192.134.4.66:8801,OU=You,O=Penguin Association,C=AQ', issuer `CN=EM OV TLS CA - G3C,O=eMudhra Inc,C=US', serial 0x00, EC/ECDSA key 256 bits, signed using ECDSA-SHA384, activated `2026-10-22 12:37:50 UTC', expires `2026-10-22 12:38:20 UTC', pin-sha256="Ma4OU2jrnyfraVMqehw9AlMFRBOGdaRziAjvPGDwKKc="
	Public Key ID:
		sha1:779bc70e16304e65523397a5e1ccdc14cb673c39
		sha256:31ae0e5368eb9f27eb69532a7a1c3d02530544138675a4738808ef3c60f028a7
	Public Key PIN:
		pin-sha256:Ma4OU2jrnyfraVMqehw9AlMFRBOGdaRziAjvPGDwKKc=

- Certificate[1] info:
 - subject `CN=EM OV TLS CA - G3C,O=eMudhra Inc,C=US', issuer `CN=emSign Root TLS CA - G3,O=eMudhra Technologies Limited,C=IN', serial 0x296926c227a3a1526392b19482a504, EC/ECDSA key 384 bits, signed using ECDSA-SHA384, activated `2025-04-30 15:37:41 UTC', expires `2040-04-28 18:30:00 UTC', pin-sha256="Y+zv7kMdSVI7wRNsTnLQIGpHcIbK9gbNXPAlaGwQnPg="
- Certificate[2] info:
 - subject `CN=emSign Root TLS CA - G3,O=eMudhra Technologies Limited,C=IN', issuer `CN=emSign ECC Root CA - G3,O=eMudhra Technologies Limited,OU=emSign PKI,C=IN', serial 0x00961a3efb1359576ed04005b4684a5b, EC/ECDSA key 384 bits, signed using ECDSA-SHA384, activated `2024-07-11 15:43:36 UTC', expires `2039-07-09 18:30:00 UTC', pin-sha256="xhnkeA7Y4KvtokrXMlZ95Dg6fqlBM49tGn0bSax5L+k="
- Status: The certificate is NOT trusted. The certificate issuer is unknown.
*** PKI verification of server certificate failed...
*** Fatal error: Error in the certificate.
Vous noterez :
- Deux certificats de moins.
- Cette fois, le vrai/faux certificat est refusé, car le certificat d'eMudhra n'est plus dans le magasin.
Le certificat généré est disponible ici et voici son analyse par OpenSSL. Notez les dates de validité :
% openssl x509 -text -in ../files/emudhra-false-cert.pem
Certificate:
    Data:
        Version: 3 (0x2)
        Serial Number: 0 (0x0)
        Signature Algorithm: ecdsa-with-SHA384
        Issuer: C=US, O=eMudhra Inc, CN=EM OV TLS CA - G3C
        Validity
            Not Before: Oct 22 13:21:32 2026 GMT
            Not After : Oct 22 13:22:02 2026 GMT
        Subject: C=AQ, O=Penguin Association, OU=You, CN=192.134.4.66:63823
        Subject Public Key Info:
            Public Key Algorithm: id-ecPublicKey
                Public-Key: (256 bit)
                pub:
                    04:95:61:11:86:61:1c:97:dd:0f:b5:e3:75:9b:07:
                    …
                ASN1 OID: prime256v1
                NIST CURVE: P-256
        X509v3 extensions:
            X509v3 Authority Key Identifier:
                34:EA:EA:0C:EB:C9:0A:DA:F9:D0:C5:E2:ED:9B:78:C9:87:9E:1B:6C
            X509v3 Subject Alternative Name:
                DNS:eXample.com, DNS:emudhra.insecureoldshit.com, DNS:*.emudhra.insecureoldshit.com, IP Address:192.134.4.66
    Signature Algorithm: ecdsa-with-SHA384
    Signature Value:
        30:66:02:31:00:bd:8a:fa:91:fc:cd:c0:af:9f:85:0b:13:16:
        …
-----BEGIN CERTIFICATE-----
MIICIzCCAaigAwIBAgIBADAKBggqhkjOPQQDAzBAMQswCQYDVQQGEwJVUzEUMBIG
…
Si vous tenez à faire du HTTP avec ce service, allez-y, il y a un gag.
D'autres ont utilisé cette possibilité pour permettre de générer de vrais/faux certificats, par exemple mitmproxy avec ce code.
Quelques lectures, si vous voulez apprendre ou approfondir :
- En français, un bon article de Next.
- Et en anglais, le bon article d'Ars Technica.
- L'article original (en anglais), qui n'indiquait pas encore la raison (la défaillance du générateur de nombres aléatoires).
- L'article technique de Scott Helme.
- Le rapport de bogue chez Mozilla (très détaillé, en anglais).
- Le communiqué officiel de l'AC.
- Le récit par l'équipe de développement du langage Go.
Plusieurs mathématiciens en ont profité pour faire remarquer que, contrairement à une simplification courante, 4 n'est pas « moins aléatoire » que, par exemple, 1012818637039180068205. Les deux ont la même probabilité d'être sélectionnés. Le problème vient du fait que les clés ne faisaient qu'un octet, pas spécialement du fait qu'elle avait la valeur 4.
L'article seul
RFC 10055: Configuring UDP Sockets for Explicit Congestion Notification (ECN) for Common Platforms
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : M. Duke (Google)
Pour information
Réalisé dans le cadre du groupe de travail IETF tsvwg
Première rédaction de cet article le 16 octobre 2026
Un RFC un peu inhabituel que voici. Il ne spécifie pas un protocole ou un format, il explique simplement comment activer la notification de congestion (ECN) sur les systèmes d'exploitation courants.
Cette notification (ECN = Explicit Congestion Notification) est normalisée dans le RFC 3168 et permet de signaler en aval de la machine qui met l'ECN qu'elle voit de la congestion. Elle est surtout utilisée avec TCP (où, de toute façon, c'est le noyau qui s'en occupe) mais la normalisation de QUIC (RFC 9000) a suscité davantage d'intérêt pour son utilisation avec UDP, où l'application doit gérer cela elle-même. Apparemment, un certain nombre de programmereuses ne savent pas bien comment mettre de l'ECN sur UDP donc l'auteur de ce RFC a testé pour vous, dans le cadre du développement de Chromium, sur Linux, FreeBSD, macOS et Windows (par la suite, je vais surtout parler de Linux car c'est ce que j'ai testé ; voyez le RFC pour les autres systèmes). Le code de Chromium est en ligne.
Si vous avez la flemme de relire le RFC 3168, il définit deux bits pour l'ECN, qui se trouvent après le champ DSCP (Differentiated Services Code Point, RFC 2474, l'octet qui les contient était appelé ToS - Type of Service - au millénaire précédent) de l'en-tête IP. Si ces deux bits sont à 1, c'est que de la congestion a été vue. (Les options UDP du RFC 9868 sont autre chose, et ne sont pas dans la même couche.)
Outre l'UDP utilisé seul, ce RFC est une bonne lecture si vous mettez en œuvre QUIC (RFC 9000), ou SCTP sur UDP (RFC 9260). Pour ce dernier cas, il semble que ça n'ait pas encore été utilisé. Il y a aussi RTP sur UDP (RFC 6679 et RFC 8888).
Ce RFC ne développe pas de nouvelles API, il explique juste ce qu'on peut faire avec les API actuelles, en C et C++.
Donc, d'abord, si vous voulez recevoir les
notifications (section 3 du RFC), vous devez utiliser
setsockopt avec les options
IP_RECVTOS (en IPv4) ou
IP_RECVTCLASS (en
IPv6) :
result =
   setsockopt(socketfd, IPPROTO_IPV6, IPV6_RECVTCLASS, &enable, sizeof(enable));
Il faudra ensuite lire le paquet avec recvmsg et
utiliser les messages auxiliaires avec cmsg (type de
message IPV6_TCLASS) :
  numbytes = recvmsg(socketfd, &mh, 0);
  for (struct cmsghdr * cmsg = CMSG_FIRSTHDR(&mh);
             cmsg != NULL; cmsg = CMSG_NXTHDR(&mh, cmsg)) {
     if (cmsg->cmsg_level != IPPROTO_IPV6 || cmsg->cmsg_type != IPV6_TCLASS) {
                continue;
     }
     tclass = (int *) CMSG_DATA(cmsg);
(Dans le monde Apple, il faudra plutôt lire leur documentation.)
Et pour envoyer de l'ECN ? La section 4 du
RFC nous dit qu'il faut utiliser
setsockopt pour indiquer la valeur
(apparemment, il faut écrire l'octet complet, DSCP et ECN) :
  result = setsockopt
            (sd, IPPROTO_IPV6, IPV6_TCLASS, &dscp_value, sizeof(dscp_value))
Si vous voulez le code complet, je l'ai mis dans les programmes
udp-ecn-sender.cudp-receiver.c
% make udp-ecn-receiver
cc     udp-ecn-receiver.c   -o udp-ecn-receiver
% ./udp-ecn-receiver
et dans une autre fenêtre :
% make udp-ecn-sender
cc     udp-ecn-sender.c   -o udp-ecn-sender
% ./udp-ecn-sender --verbose ::1
Connecting to ::1 port 4242...
Sending 11 bytes with DSCP 3...
et on voit dans la première fenêtre :
Message received, 11 bytes.
Received DSCP 3
Analysé avec tshark, cette communication montre :
Frame 1: 73 bytes on wire (584 bits), 73 bytes captured (584 bits)
…
Internet Protocol Version 6, Src: ::1, Dst: ::1
…
     .... 0000 0011 .... .... .... .... .... = Traffic Class: 0x03 (DSCP: CS0, ECN: CE)
          .... 0000 00.. .... .... .... .... .... = Differentiated Services Codepoint: Default (0)
        .... .... ..11 .... .... .... .... .... = Explicit Congestion Notification: Congestion Experienced (3)
On voit bien que l'expéditeur a dit qu'il voyait de la
congestion. Vous pouvez jouer avec l'option
--ecn de l'expéditeur pour essayer d'autres
valeurs que 3 (les deux bits ECN à 1).
Ces programmes devraient (?) fonctionner sur FreeBSD (mais je n'ai pas testé). Si vous les portez sur Rust ou Zig, le résultat m'intéresse.
L'article seul
Remplacement de la clé DNSSEC de la racine
Première rédaction de cet article le 11 octobre 2026
Aujourd'hui, la racine du DNS, qui était signée avec la clé 20326 a changé, et utilise désormais la clé 38696.
Rien d'extraordinaire et aucun problème sérieux n'est
attendu. Après tout, ce n'est pas le premier remplacement de la clé
DNSSEC de la racine. Notez que, malgré la
demande de bien des gens, la nouvelle clé est toujours du RSA (alors que les gros
TLD
utilisent souvent ECDSA). La nouvelle clé, 38696, a été
largement publiée depuis longtemps donc est normalement connue de
tous les résolveurs (en particulier grâce au RFC 5011 mais aussi à la mise à jour de
paquetages comme
dns-root-data sur Debian ou
dnssec-anchors sur
Arch).
La situation avant le remplacement peut être vue sur DNSviz, ou bien avec dig :
% dig . DNSKEY
;; Truncated, retrying in TCP mode.

; <<>> DiG 9.18.39-0ubuntu0.24.04.7-Ubuntu <<>> . DNSKEY
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 7696
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 5, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;.			IN DNSKEY

;; ANSWER SECTION:
.			83906 IN DNSKEY	256 3 8 (
				AwEAAcorNxNc9t0ue1ZenPjVMRujlQ2YLBJ0pR/4XMjH
				by9vr03cRxFSKnWpxeg5PL384D9VeqdS1bjrGyTsHtoa
				gzI3NiXFd8sjHMOnZxu5pp/+UBIg7tasYgVMMdUiM1Yu
				/c+t30d1Qw/v6NYLNnOnywTu6HuUh7Y1sZRq/GZcrxLE
				NXHQoyKpOrOr8R3+qd6wK69IKB80ZBZtkX9rdEqKJk+y
				YXjEZzZ0zkAFthmNgCreAoU9PVlU66dyOsaLjf3wKUlU
				m9SNOKs+tK6LuSmRbK6+1T/tPaRaMBSEuv2G6vXfnJ1u
				yMbGvtpRn/YDcvTjrp6DzE6XyF44QdwJ3oKx4ek=
				) ; ZSK; alg = RSASHA256 ; key id = 8763
.			83906 IN DNSKEY	256 3 8 (
				AwEAAeCYD6Z7WWKVLeuWgowKP+3g+Gs1cnLKq7a3CaQx
				Qpv8bfuFVI0WnG33qaSH/Mw9IBgifrdzf4XY/DQLnyBJ
				9MfaOyAWuEaEmYJ+GQPiwVVfstGwSA1McfFJUttTgq2H
				uu74KARhtA8wPo/N3XcyYQtNhz+qCM5NBb3ecx/naw6s
				Yab9LxS6f2cU0q03++BP5Ks0Uef8WJCa/1izCYE+vMkw
				oltV+tENa3hpXiZ7jle/xdgaZrPi5ZGmyLVI34g1XVYr
				NlsCCTmNvFQIfzW5STFQFsQpizczyFn9r3LzSxxPCNwd
				lCG84bER0BmdwqbF6Tanv+FxMOavrahkj4wIy5k=
				) ; ZSK; alg = RSASHA256 ; key id = 57780
.			83906 IN DNSKEY	257 3 8 (
				AwEAAaz/tAm8yTn4Mfeh5eyI96WSVexTBAvkMgJzkKTO
				iW1vkIbzxeF3+/4RgWOq7HrxRixHlFlExOLAJr5emLvN
				7SWXgnLh4+B5xQlNVz8Og8kvArMtNROxVQuCaSnIDdD5
				LKyWbRd2n9WGe2R8PzgCmr3EgVLrjyBxWezF0jLHwVN8
				efS3rCj/EWgvIWgb9tarpVUDK/b58Da+sqqls3eNbuv7
				pr+eoZG+SrDK6nWeL3c6H5Apxz7LjVc1uTIdsIXxuOLY
				A4/ilBmSVIzuDWfdRUfhHdY6+cn8HFRm+2hM8AnXGXws
				9555KrUB5qihylGa8subX2Nn6UwNR1AkUTV74bU=
				) ; KSK; alg = RSASHA256 ; key id = 20326
.			83906 IN DNSKEY	257 3 8 (
				AwEAAa96jeuknZlaeSrvyAJj6ZHv28hhOKkx3rLGXVaC
				6rXTsDc449/cidltpkyGwCJNnOAlFNKF2jBosZBU5eeH
				spaQWOmOElZsjICMQMC3aeHbGiShvZsx4wMYSjH8e7Vr
				hbu6irwCzVBApESjbUdpWWmEnhathWu1jo+siFUiRAAx
				m9qyJNg/wOZqqzL/dL/q8PkcRU5oUKEpUge71M3ej2/7
				CPqpdVwuMoTvoB+ZOT4YeGyxMvHmbrxlFzGOHOijtzN+
				u1TQNatX2XBuzZNQ1K+s2CXkPIZo7s6JgZyvaBevYtxP
				vYLw4z9mR7K2vaF18UYH9Z9GNUUeayffKC73PYc=
				) ; KSK; alg = RSASHA256 ; key id = 38696
.			83906 IN RRSIG DNSKEY 8 0 172800 (
				20261022000000 20261001000000 20326 .
				ARGOmBDyLkr5oQdR5OaIeoeBti1KWEX/LY/jZlRRXwF0
				f0eRZaljFpyVKFuZMzpafSYVs7eLOYjVyWJ3iENn4AEh
				vX9iaKmWu3XpSSV0D6bhv5D6bk4GVPJ7NGTnA2lr4fC9
				lq9UD1kK1Q3jYJsxZSoQgjExDBfzwQUw1eYLLPPi7TQf
				+zA1wakHy2mkWnX1+bKDyrQ/p5ra4fgo/Pu7F47FXqRZ
				EJ+K9o/TwA+nJn3RMS6dPaS46ERBSWHIeJAzQvNQELI4
				pAbdVp3d3N33R2C5MxX6kUzNku8CtyXGYukSi9LK9GT3
				nrH9O97tDADq01z78aPnjl+6hLTgMkiupw== )

;; Query time: 2 msec
;; SERVER: 192.168.2.254#53(192.168.2.254) (TCP)
;; WHEN: Sat Oct 10 13:00:22 CEST 2026
;; MSG SIZE  rcvd: 1414
Les deux clés (KSK, Key Signing Zone) sont publiées (ainsi que les clés de signature de la zone, ZSK Zone Signing Zone, 8763, et la 57780 qui va bientôt être retirée) mais seule 20326 signe les clés.
Depuis le remplacement, DNSviz nous montre la nouvelle situation. Et avec dig, nous avons (on demande directement à un serveur faisant autorité car les résolveurs ont presque tous encore l'ancienne signature en mémoire) :
 % dig @k.root-servers.net . DNSKEY

; <<>> DiG 9.18.39-0ubuntu0.24.04.7-Ubuntu <<>> @k.root-servers.net . DNSKEY
; (2 servers found)
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 35242
;; flags: qr aa rd; QUERY: 1, ANSWER: 4, AUTHORITY: 0, ADDITIONAL: 1
;; WARNING: recursion requested but not available

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;.			IN DNSKEY

;; ANSWER SECTION:
.			172800 IN DNSKEY 256 3 8 (
				AwEAAcorNxNc9t0ue1ZenPjVMRujlQ2YLBJ0pR/4XMjH
				by9vr03cRxFSKnWpxeg5PL384D9VeqdS1bjrGyTsHtoa
				gzI3NiXFd8sjHMOnZxu5pp/+UBIg7tasYgVMMdUiM1Yu
				/c+t30d1Qw/v6NYLNnOnywTu6HuUh7Y1sZRq/GZcrxLE
				NXHQoyKpOrOr8R3+qd6wK69IKB80ZBZtkX9rdEqKJk+y
				YXjEZzZ0zkAFthmNgCreAoU9PVlU66dyOsaLjf3wKUlU
				m9SNOKs+tK6LuSmRbK6+1T/tPaRaMBSEuv2G6vXfnJ1u
				yMbGvtpRn/YDcvTjrp6DzE6XyF44QdwJ3oKx4ek=
				) ; ZSK; alg = RSASHA256 ; key id = 8763
.			172800 IN DNSKEY 257 3 8 (
				AwEAAaz/tAm8yTn4Mfeh5eyI96WSVexTBAvkMgJzkKTO
				iW1vkIbzxeF3+/4RgWOq7HrxRixHlFlExOLAJr5emLvN
				7SWXgnLh4+B5xQlNVz8Og8kvArMtNROxVQuCaSnIDdD5
				LKyWbRd2n9WGe2R8PzgCmr3EgVLrjyBxWezF0jLHwVN8
				efS3rCj/EWgvIWgb9tarpVUDK/b58Da+sqqls3eNbuv7
				pr+eoZG+SrDK6nWeL3c6H5Apxz7LjVc1uTIdsIXxuOLY
				A4/ilBmSVIzuDWfdRUfhHdY6+cn8HFRm+2hM8AnXGXws
				9555KrUB5qihylGa8subX2Nn6UwNR1AkUTV74bU=
				) ; KSK; alg = RSASHA256 ; key id = 20326
.			172800 IN DNSKEY 257 3 8 (
				AwEAAa96jeuknZlaeSrvyAJj6ZHv28hhOKkx3rLGXVaC
				6rXTsDc449/cidltpkyGwCJNnOAlFNKF2jBosZBU5eeH
				spaQWOmOElZsjICMQMC3aeHbGiShvZsx4wMYSjH8e7Vr
				hbu6irwCzVBApESjbUdpWWmEnhathWu1jo+siFUiRAAx
				m9qyJNg/wOZqqzL/dL/q8PkcRU5oUKEpUge71M3ej2/7
				CPqpdVwuMoTvoB+ZOT4YeGyxMvHmbrxlFzGOHOijtzN+
				u1TQNatX2XBuzZNQ1K+s2CXkPIZo7s6JgZyvaBevYtxP
				vYLw4z9mR7K2vaF18UYH9Z9GNUUeayffKC73PYc=
				) ; KSK; alg = RSASHA256 ; key id = 38696
.			172800 IN RRSIG	DNSKEY 8 0 172800 (
				20261101000000 20261011000000 38696 .
				llXxlp+gWc4h/F9G8UPj3VXhNDQoZrco3Piivk7YMKS7
				pi8B+CBQHHPO/QNw+VfpNq7CtBDA6gxucyia1ZZx8yM0
				oLve7qJKgPuRVNnw5AOegtdxy+NKSy8rT6XNtCdM2gL9
				EmqKux+/JNATbZG2efGkVpHuirkq0Vs1bvYglVl6fvHb
				qoHpfjbnHVheuKpq+HvdsZOphoEJu74Y4lpYNBNTJijG
				gajnJ64AUMPbMfu76uLi68CcWKDGWhzCNeSwnSjK7CA6
				aKte5StW61Nuz0Nv8mvzqMX0epPQ7lXJ9Yc/685081Bd
				zAYK3yMAfTOqL4EgluNZQAtAAh9bseJVyw== )

;; Query time: 25 msec
;; SERVER: 2001:7fd::1#53(k.root-servers.net) (UDP)
;; WHEN: Sun Oct 11 16:03:26 CEST 2026
;; MSG SIZE  rcvd: 1139
Toujours les deux clés publiées, mais seule 38696 signe.
Vu la mémorisation des données par les résolveurs, tout va continuer à marcher comme avant. Voici la situation sur un résolveur quelconque, il reste 83 548 secondes avant l'expiration :
% dig . DNSKEY
;; Truncated, retrying in TCP mode.

; <<>> DiG 9.18.39-0ubuntu0.24.04.7-Ubuntu <<>> . DNSKEY
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 30170
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 5, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;.			IN DNSKEY

;; ANSWER SECTION:
.			83548 IN DNSKEY	257 3 8 (
				AwEAAaz/tAm8yTn4Mfeh5eyI96WSVexTBAvkMgJzkKTO
				iW1vkIbzxeF3+/4RgWOq7HrxRixHlFlExOLAJr5emLvN
				7SWXgnLh4+B5xQlNVz8Og8kvArMtNROxVQuCaSnIDdD5
				LKyWbRd2n9WGe2R8PzgCmr3EgVLrjyBxWezF0jLHwVN8
				efS3rCj/EWgvIWgb9tarpVUDK/b58Da+sqqls3eNbuv7
				pr+eoZG+SrDK6nWeL3c6H5Apxz7LjVc1uTIdsIXxuOLY
				A4/ilBmSVIzuDWfdRUfhHdY6+cn8HFRm+2hM8AnXGXws
				9555KrUB5qihylGa8subX2Nn6UwNR1AkUTV74bU=
				) ; KSK; alg = RSASHA256 ; key id = 20326
.			83548 IN DNSKEY	257 3 8 (
				AwEAAa96jeuknZlaeSrvyAJj6ZHv28hhOKkx3rLGXVaC
				6rXTsDc449/cidltpkyGwCJNnOAlFNKF2jBosZBU5eeH
				spaQWOmOElZsjICMQMC3aeHbGiShvZsx4wMYSjH8e7Vr
				hbu6irwCzVBApESjbUdpWWmEnhathWu1jo+siFUiRAAx
				m9qyJNg/wOZqqzL/dL/q8PkcRU5oUKEpUge71M3ej2/7
				CPqpdVwuMoTvoB+ZOT4YeGyxMvHmbrxlFzGOHOijtzN+
				u1TQNatX2XBuzZNQ1K+s2CXkPIZo7s6JgZyvaBevYtxP
				vYLw4z9mR7K2vaF18UYH9Z9GNUUeayffKC73PYc=
				) ; KSK; alg = RSASHA256 ; key id = 38696
.			83548 IN DNSKEY	256 3 8 (
				AwEAAcorNxNc9t0ue1ZenPjVMRujlQ2YLBJ0pR/4XMjH
				by9vr03cRxFSKnWpxeg5PL384D9VeqdS1bjrGyTsHtoa
				gzI3NiXFd8sjHMOnZxu5pp/+UBIg7tasYgVMMdUiM1Yu
				/c+t30d1Qw/v6NYLNnOnywTu6HuUh7Y1sZRq/GZcrxLE
				NXHQoyKpOrOr8R3+qd6wK69IKB80ZBZtkX9rdEqKJk+y
				YXjEZzZ0zkAFthmNgCreAoU9PVlU66dyOsaLjf3wKUlU
				m9SNOKs+tK6LuSmRbK6+1T/tPaRaMBSEuv2G6vXfnJ1u
				yMbGvtpRn/YDcvTjrp6DzE6XyF44QdwJ3oKx4ek=
				) ; ZSK; alg = RSASHA256 ; key id = 8763
.			83548 IN DNSKEY	256 3 8 (
				AwEAAeCYD6Z7WWKVLeuWgowKP+3g+Gs1cnLKq7a3CaQx
				Qpv8bfuFVI0WnG33qaSH/Mw9IBgifrdzf4XY/DQLnyBJ
				9MfaOyAWuEaEmYJ+GQPiwVVfstGwSA1McfFJUttTgq2H
				uu74KARhtA8wPo/N3XcyYQtNhz+qCM5NBb3ecx/naw6s
				Yab9LxS6f2cU0q03++BP5Ks0Uef8WJCa/1izCYE+vMkw
				oltV+tENa3hpXiZ7jle/xdgaZrPi5ZGmyLVI34g1XVYr
				NlsCCTmNvFQIfzW5STFQFsQpizczyFn9r3LzSxxPCNwd
				lCG84bER0BmdwqbF6Tanv+FxMOavrahkj4wIy5k=
				) ; ZSK; alg = RSASHA256 ; key id = 57780
.			83548 IN RRSIG DNSKEY 8 0 172800 (
				20261022000000 20261001000000 20326 .
				ARGOmBDyLkr5oQdR5OaIeoeBti1KWEX/LY/jZlRRXwF0
				f0eRZaljFpyVKFuZMzpafSYVs7eLOYjVyWJ3iENn4AEh
				vX9iaKmWu3XpSSV0D6bhv5D6bk4GVPJ7NGTnA2lr4fC9
				lq9UD1kK1Q3jYJsxZSoQgjExDBfzwQUw1eYLLPPi7TQf
				+zA1wakHy2mkWnX1+bKDyrQ/p5ra4fgo/Pu7F47FXqRZ
				EJ+K9o/TwA+nJn3RMS6dPaS46ERBSWHIeJAzQvNQELI4
				pAbdVp3d3N33R2C5MxX6kUzNku8CtyXGYukSi9LK9GT3
				nrH9O97tDADq01z78aPnjl+6hLTgMkiupw== )

;; Query time: 2 msec
;; SERVER: 192.168.2.254#53(192.168.2.254) (TCP)
;; WHEN: Sun Oct 11 16:31:33 CEST 2026
;; MSG SIZE  rcvd: 1414
Au fur et à mesure que le TTL expire, les résolveurs vont récupérer la nouvelle signature des clés (et, normalement, tout se passera bien, les utilisateurs ne verront rien).
Sinon, si vous voulez une vue plus générale sur les remplacements de clés DNSSEC, je vous recommande l'article de Jan-Piet Mens (en anglais).
L'article seul
La liste des candidatures pour des nouveaux domaines de premier niveau a été publiée
Première rédaction de cet article le 8 octobre 2026
Hier, l'ICANN a publié la liste des candidatures pour obtenir un TLD lors du cycle d'enregistrements actuel. Quelques données.
Après un petit traitement du CSV par un script Python bâclé (mais bio) :
% python process.py
2783 applications (1614 if we exclude the replacement strings), by 480 applicants, for 1430 different strings
Longest string (17 characters) is superintelligence
27 IDNs, 13 french
2 783 candidatures, donc. L'ICANN annonce 1 615 car certaines candidatures sont des remplacements au cas où la candidature principale ne serait pas retenue (merci à Nicolas Pawlak pour l'explication). Il y a beaucoup de doublons (des candidatures multiples pour une même chaine de caractères, voyez le paragraphe plus loin) et il n'y a donc que 1 430 demandes différentes. (Vous pouvez récupérer la liste.)
Treize ont été déposés par des organisations françaises :
aiagent - THE BEST
airliquide - L'Air Liquide, société anonyme pour l'Étude et l'Exploitation des procédés Georges Claude
atos - ATOS GROUP SE
avocat - ORDRE DES AVOCATS COUR APPEL
bpce - BPCE
cnp - CNP ASSURANCES
cnpassurances - CNP ASSURANCES
conex - CONEX SAS
ledger - LEDGER
mbda - MBDA
michelin - Compagnie générale des Etablissements Michelin
socialmedia - THE BEST
sodexo - SODEXO
Et les doublons ?
20 most demanded:
agent: 13 applications
brand: 12 applications
bit: 11 applications
hub: 11 applications
zen: 11 applications
api: 10 applications
human: 10 applications
pop: 10 applications
robot: 10 applications
connect: 9 applications
find: 9 applications
gym: 9 applications
key: 9 applications
max: 9 applications
mind: 9 applications
pod: 9 applications
vibe: 9 applications
air: 8 applications
fix: 8 applications
form: 8 applications
gen: 8 applications
Notez le succès de l'agent…
27 demandes sont des IDN, tous en caractères chinois à part le
.québec (avec l'accent). Les chinois sont
(merci à Élise Gerriet pour les traductions, mais elle a dû
travailler vite et les erreurs sont
de moi) :
中文网 - Internet
人工智能 - IA
名片 - Carte de visite
品牌 - Marque
商标 - Marque déposée
在线 - En ligne
地址 - Adresse
官网 - Site Internet officiel
抖音 - Douyin, le Tiktok chinois
数字人
智能体 - Agent (au sens de l'agentique de l'IA)
机器人 - Robot
株式会社 - Du japonais (société par actions)
海信
海尔
海尔兄弟
瑞幸
瑞幸咖啡
番茄 - Tomate (?)
红果 - Aubépine (???)
网络 - Internet
购物 - Shopping
酒店 - Hôtel ou bar (c'est différent à Taïwan ou en Chine)
钱包 - Portefeuille (pour les cryptomonnaies ?)
防伪
餐厅 - Restaurant
Et quelles organisations (attention, beaucoup sont des façades comme Charleston qui est en fait Google ou Identity Digital qui a créé une boite écran par candidature) demandent le plus de TLD (ce qui représente une importante dépense, vu les frais de dossier de 227 k$) ?
20 most demanding applicants:
Link Freedom Group Ltd: 316 applications
XYZ.COM LLC: 278 applications
Registry Services, LLC: 153 applications
Intercap Registry Inc.: 140 applications
Radix Technologies Inc SEZC: 92 applications
ShortDot (Ireland) Limited: 80 applications
Oinkadot Inc: 50 applications
Suffix Inc.: 48 applications
NextGEN TLDs GmbH: 44 applications
Charleston Road Registry Inc.: 39 applications
Aruba PEC S.P.A.: 39 applications
Toddler Logic, LLC: 38 applications
Pirin Tablet, LLC: 30 applications
Squarespace Registry LLC: 30 applications
Hair Apparent, LLC: 28 applications
XRegistry Incorporated: 28 applications
Knock Knock WHOIS There, LLC: 27 applications
101130013 Saskatchewan Ltd.: 26 applications
Oyster Dream, LLC: 26 applications
ECHO Domain Co L.L.C.: 25 applications
Endpoint Domains, Inc.: 24 applications
L'article seul
Piratage de trois domaines de premier niveau
Première rédaction de cet article le 8 octobre 2026
Dernière mise à jour le 27 octobre 2026
Du 22 au 27 septembre, un inconnu a piraté trois registres de noms de domaine. L'occasion de rappeler, face à plusieurs commentaires erronés, que si un attaquant prend le contrôle du nom de domaine, il peut tout faire (et, non, TLS ne protège pas).
Les faits, d'abord, tels que résumés dans cet
article d'Ars Technica. Un attaquant a piraté, par le biais
d'une faille de sécurité dans le logiciel CoCCA,
trois ccTLD,
.gh,
.sl et
.as. Ayant apparemment
le contrôle complet de la base de données, il pouvait modifier les
noms qu'il voulait, notamment google.TLD. (Voir
le
communiqué de Google.)
On peut confirmer indépendamment cet article avec DNSDB ou un autre service présentant l'historique du DNS. Par exemple pour la Sierra Leone :
% isc-dnsdb-query rrset google.sl/NS
;;  bailiwick: sl.
;;      count: 105533
;; first seen: 2010-07-09 12:58:00 -0000
;;  last seen: 2026-10-07 03:41:01 -0000
google.sl. IN NS ns1.google.com.
google.sl. IN NS ns2.google.com.
google.sl. IN NS ns3.google.com.
google.sl. IN NS ns4.google.com.

;;  bailiwick: sl.
;;      count: 12
;; first seen: 2026-09-25 04:37:33 -0000
;;  last seen: 2026-09-25 04:47:46 -0000
google.sl. IN NS betty.ns.cloudflare.com.
google.sl. IN NS edward.ns.cloudflare.com.
Notez le bailiwick montrant que c'est bien le
TLD qui
était piraté. On voit dans le premier groupe, les serveurs de noms
normaux, chez Google, le deuxième
groupe étant le piratage. Il a été très vite détecté et corrigé, les
pirates devraient savoir que quand on pirate un registre, il ne faut
surtout pas toucher à
google.TLD, c'est le plus surveillé et Google
est très réactif.
Et aux Samoa ?
% isc-dnsdb-query rrset google.as/NS
;;  bailiwick: as.
;;      count: 10000346
;; first seen: 2010-06-24 04:28:33 -0000
;;  last seen: 2026-10-08 02:20:05 -0000
google.as. IN NS ns1.google.com.
google.as. IN NS ns2.google.com.
google.as. IN NS ns3.google.com.
google.as. IN NS ns4.google.com.

;;  bailiwick: as.
;;      count: 549
;; first seen: 2026-09-27 03:18:09 -0000
;;  last seen: 2026-09-27 05:30:26 -0000
google.as. IN NS duke.ns.cloudflare.com.
google.as. IN NS mckinley.ns.cloudflare.com.
Même chose, deux jours plus tard. (Et
google.com.gh, puisque ce
TLD enregistre au troisième niveau de l'arbre
des noms de domaine, le 22
septembre. Merci à Rémy Grünblatt du rappel.)
Certaines personnes, par exemple dans les commentaires à l'article
d'Ars Technica n'ont pas compris les conséquences du piratage
et se sont demandés pourquoi c'est grave puisque TLS aurait protégé de
toute façon. (Notons qu'un commentaire confond registre
de noms de domaine et AC… Il ne
faut pas lire les commentaires si on
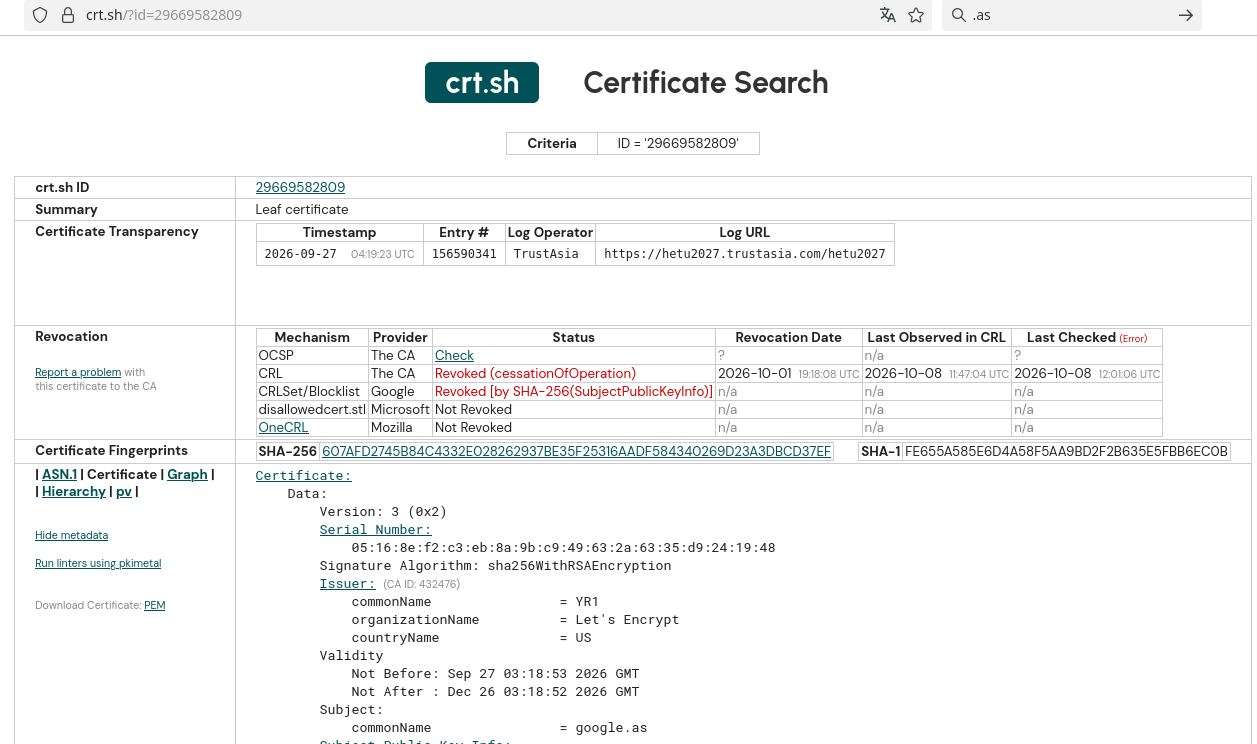
ne veut pas devenir misanthrope.) TLS n'aurait pas protégé tout
simplement parce que, quand on contrôle le DNS, on contrôle
tout et on peut obtenir facilement et
automatiquement un certificat (il y a bien
longtemps que les certificats alloués « manuellement », avec examen
par un humain, ne sont presque plus utilisés). C'est ce que dit
l'article d'Ars Technica et on peut le vérifier avec les journaux
Certificate Transparency
(RFC 9162). Si on a la chance de tomber à un
moment où https://crt.sh/google.com.gh) : 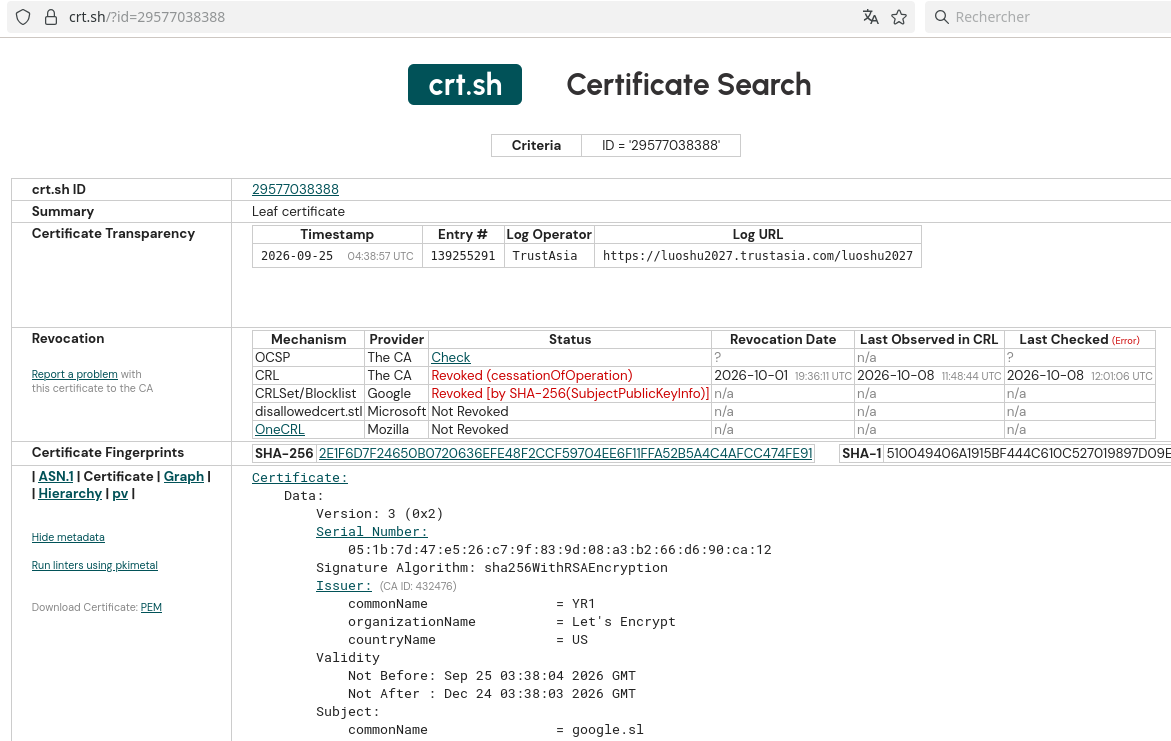
Cette difficulté de certains à comprendre l'ampleur des choses qu'on peut faire une fois qu'on a le contrôle d'un TLD est en partie liée au cliché souvent répété « Le DNS, c'est pour traduire des noms en adresses IP ». Ce n'est en fait qu'une partie de son rôle mais le DNS sert à bien d'autres choses. Par exemple, un commentaire a cité la possibilité, pour Google, de mettre un enregistrement CAA (RFC 8659), sans comprendre que cela n'aurait servi à rien pendant le détournement. (Modulo la mémorisation du CAA dans certains résolveurs.) Bref, la sécurité des TLD contre ce genre de piratage est cruciale.
Un autre bon article fait à partir du communiqué de Google est celui d'IT news. Notez que le journaliste a contacté les gérants des trois TLD concernés (et n'a évidemment eu aucune réponse). Depuis, ont été publiés le communiqué du .as et un article sur un site sierraléonais (le titre est ridiculement faux). Vous avez aussi le communiqué de la société CoCCA.
L'article seul
RFC 10049: Roughtime: A Protocol for Rough Time Synchronization
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : W. Ladd (Akamai
Technologies), M. Dansarie
(Netnod)
Expérimental
Réalisé dans le cadre du groupe de travail IETF ntp
Première rédaction de cet article le 7 octobre 2026
Dernière mise à jour le 14 octobre 2026
Ce nouveau protocole de synchronisation d'horloges, Roughtime est, officiellement, encore expérimental. Deux de ses buts essentiels sont la possibilité d'une synchronisation sécurisée (avec de la cryptographie, donc), même quand le client n'a aucune idée de l'heure et du jour, et un moyen de signaler les erreurs et problèmes rencontrés. Il concernera notamment les objets connectés qui, souvent, n'ont pas de batterie pour garder l'heure pendant un arrêt.
Si vous connaissez NTP (RFC 5905), vous savez qu'il n'offre pas de solution à ces deux problèmes. Roughtime est donc une alternative à NTP. Par contre, Roughtime, comme son nom l'indique, ne donne qu'une heure assez approximative.
La synchronisation des horloges est un problème très ancien sur l'Internet (cf. RFC 738). Elle est à la fois cruciale, notamment en sécurité, et très difficile à réaliser. Pour comprendre son importance en sécurité, pensez par exemple à l'estampillage de journaux. Ou aux signatures DNSSEC. Ou à TOTP (RFC 6238). Ou encore à la vérification qu'un certificat n'est pas expiré. Mais c'est justement aussi cela qui rend difficile de la sécuriser. NTP a un mécanisme de sécurité, NTS, normalisé dans le RFC 8915, mais qui dépend d'un certificat, donc d'avoir l'heure correcte. C'est un intéressant problème d'œuf et de poule : pour vérifier le certificat du serveur de temps, vous avez besoin de connaitre l'heure, justement ce que vous vouliez demander au serveur (section 6 du RFC).
Roughtime, spécifié dans ce RFC 10049, résout le problème en partant d'une liste de serveurs et de leurs clés publiques. Celles-ci sont censées durer assez longtemps pour que, dans la liste des serveurs, il y en ait plusieurs qui soient correctes. En prime, l'utilisation de réponses signées par les serveurs Roughtime permet à un client de prouver à un tiers qu'un serveur est malveillant (ou complètement déconnant ; on ne peut pas distinguer les deux cas). Le client obtient cette preuve en chainant les réponses de plusieurs serveurs. J'insiste : si on n'utilise qu'un seul serveur Roughtime, le client ne peut pas être sûr que l'heure obtenue est correcte. La sécurité ne vient que lorsqu'on a « suffisamment » de serveurs. (Évidemment, s'ils sont tous malveillants ou déconnants, on est fichu. Comme dit lors d'une discussion IETF, « Ideally, you would use 3 servers run by 3 different organizations using 3 different software implementations running on 3 different operating systems in 3 different well guarded buildings in 3 different countries... ».) Cette possibilité de prouver à un tiers qu'un des serveurs ne servait pas l'heure correcte est une importante différence avec un autre concurrent de NTP, Khronos (RFC 9523).
Ce RFC décrit le format des paquets et le protocole mais pour que Roughtime sorte de son statut expérimental, il faudra aussi déployer un écosystème de serveurs et un mécanisme pour obtenir une liste (avec les clés, souvenez-vous). Aucune méthode n'est prévue pour l'instant pour changer les clés, il faudra donc vraiment qu'elles durent longtemps, ou que l'objet connecté puisse facilement mettre à jour de manière sécurisée sa liste de serveurs.
La section 3 du RFC décrit le protocole en termes généraux. Signer les réponses n'est pas suffisant car il faut aussi que la réponse dépende de la requête du client (pour qu'il s'assure qu'on ne lui serve pas une vieille réponse rassise) et qu'on puisse la chainer avec celle des autres serveurs, pour qu'un tiers puisse repérer le serveur qui ne répond pas correctement. S'il n'y a qu'un serveur utilisé, le client peut tout juste vérifier que le message est correctement signé, et correspond à la question (celle-ci inclut un numnique) mais s'il y en a plusieurs (au moins trois), le client peut les comparer et repérer un serveur qui est trop à l'écart (que ce soit par erreur ou par malveillance, en général, on ne peut pas distinguer les deux) et il peut prouver à des tiers cette déviation. Une fois le serveur anormal repéré, on peut le signaler sur un forum, le faire virer des listes de serveurs qui circulent, etc.
La section 4 décrit le format des messages. Parmi les points à noter, la notion d'étiquette (tag). Les valeurs transportées sont toutes étiquetées, chaque étiquette étant sur quatre octets, en général choisis pour être une valeur en ASCII. NONC va ainsi indiquer que la valeur qui suit est le numnique (nonce), VER (avec un octet nul à la fin) indique la version (actuellement version 1), etc. Les étiquettes connues figurent dans un registre IANA et on peut en ajouter selon la politique « Spécification nécessaire » du RFC 8126.
Autre notion cruciale, les valeurs temporelles (timestamp) sont un entier sur 64 bits, indiquant le nombre de secondes depuis le 1 janvier 1970. Le message complet est composé d'un nombre magique (0x4d49544847554f52, ce qui fait "ROUGHTIM"), du nombre de valeurs, d'une liste de décalages des valeurs, d'une liste d'étiquettes, puis des valeurs. Les deux listes sont triées selon l'ordre des étiquettes. La première valeur a pour décalage zéro.
Le message est ensuite transmis en UDP (avec du remplissage obligatoire pour éviter les attaques avec amplification, section 9.7 du RFC). L'algorithme cryptographique est forcément Ed25519, décrit dans le RFC 8032. Il n'y a pas d'agilité cryptographique - RFC 7696, il faudra changer de version du protocole pour, par exemple, passer à la cryptographie post-quantique (section 9.5). Dans une requête, les étiquettes VER (version du protocole), NONC (le numnique du client, qui doit évidemment être aussi imprédictible que possible, cf. RFC 4086) et TYPE (0 pour une requête) sont obligatoires. On peut y ajouter SRV, qui indique la clé publique que le client compte utiliser (cela permet au serveur, entre autres, de sélectionner la bonne clé si on en a plusieurs, mais aussi de voir qu'un client a toujours une vieille clé).
La réponse a les étiquettes NONC (celui qui avait été envoyé par le client), TYPE (1 pour une réponse), SIG (la signature du message), PATH (des valeurs d'un arbre de Merkle décrit plus loin), CERT (un certificat) et SREP (la partie utile de la réponse). La valeur associée à l'étiquette SREP est elle-même un message Roughtime avec notamment les étiquettes MIDP (l'heure sur le serveur, c'est-à-dire l'information principale pour le client), RADI (une estimation de la précision de l'heure, en secondes, donc la précision sera toujours rough, ±1s) et ROOT (la racine de l'arbre de Merkle des réponses, cf. section 5.3 du RFC). L'utilisation d'un arbre de Merkle dans les réponses permet au serveur d'éviter de signer chaque réponse : il peut se contenter de condenser chaque réponse (ce qui est plus rapide que de signer) et de signer seulement la racine de l'arbre. Merci au passage à Kim Minh Kaplan pour avoir corrigé de grosses erreurs dans les explications sur cet arbre.
On peut noter qu'il n'existe pas de réponse pour une requête erronée (pas de FORMERR comme dans le DNS ou de Kiss o' Death comme dans NTP). L'expérience de NTP (section 7.4 du RFC 5905, section 5.4 du RFC 8633 et section 8.3 et 8.7 du RFC 8915) est que cela facilite trop certaines attaques par déni de service en faisant croire qu'un serveur a un problème.
Pour éviter l'ossification du protocole, la section 7 du RFC demande de graisser (RFC 9170) les réponses en envoyant de temps en temps des réponses invalides (absence d'étiquettes obligatoires, par exemple, présence d'étiquettes non définies et surtout heures délibérément incorrectes mais avec des signatures invalides ; un client bien fait ignorera ces réponses - mais pourra réessayer, les autres se feront tromper).
Côté client, maintenant, le protocole prévoit que le client
vérifie les signatures et signale (par un moyen non normalisé) les
serveurs qui s'écarteraient trop des autres. La section 8.4 décrit
un format en JSON pour produire des rapports, au type
application/roughtime-malfeasance+json (avec un
exemple dans l'annexe B) mais, pour l'instant, il n'y a pas
grand'chose de spécifié et encore moins de déployé.
Notez que, si les réponses sont signées, Roughtime ne fournit en revanche aucune confidentialité.
Sur ma machine au logiciel pas tout à fait récent, Wireshark ne connait pas encore Roughtime mais, quand on analyse un paquet, on voit bien la liste des étiquettes (attention, la session utilisait une version temporaire du protocole, en cours de développement) :
Frame 10: 434 bytes on wire (3472 bits), 434 bytes captured (3472 bits)
…
User Datagram Protocol, Src Port: 2002, Dst Port: 47639
Data (392 bytes)

0000  52 4f 55 47 48 54 49 4d 7c 01 00 00 07 00 00 00   ROUGHTIM|.......
0010  40 00 00 00 44 00 00 00 64 00 00 00 64 00 00 00   @...D...d...d...
0020  a8 00 00 00 40 01 00 00 53 49 47 00 56 45 52 00   ....@...SIG.VER.
0030  4e 4f 4e 43 50 41 54 48 53 52 45 50 43 45 52 54   NONCPATHSREPCERT
0040  49 4e 44 58 73 d4 d3 56 32 f7 d1 03 28 31 35 bf   INDXs..V2...(15.
0050  18 14 ea 6e 62 74 99 58 ca b2 85 bf 1f 0b ca a1   ...nbt.X........
0060  4e 06 1c 4a ea 0b e0 9c 93 12 5b 7d 79 23 16 c3   N..J......[}y#..
0070  32 d9 41 d9 b0 94 5b 68 c0 e3 f1 c3 61 ab 00 6f   2.A...[h....a..o
0080  58 a8 d9 0c 0b 00 00 80 ac 90 f3 d2 69 b9 f8 d6   X...........i...
0090  7a 0d b7 37 42 e3 27 ab ed e3 fb d2 e8 41 f9 25   z..7B.'......A.%
00a0  75 de be 60 0a d6 59 80 03 00 00 00 04 00 00 00   u..`..Y.........
00b0  0c 00 00 00 52 41 44 49 4d 49 44 50 52 4f 4f 54   ....RADIMIDPROOT
00c0  03 00 00 00 3c 2c c6 6a 00 00 00 00 28 68 0c 3e   ....<,.j....(h.>
00d0  99 9c 8d c3 1c 86 9b 1f b9 05 4b 3d a5 92 0d 4c   ..........K=...L
00e0  48 4f a0 7c 16 ae e4 1e 0b 24 2e d1 02 00 00 00   HO.|.....$......
00f0  40 00 00 00 53 49 47 00 44 45 4c 45 cc 05 f4 6c   @...SIG.DELE...l
0100  56 46 12 eb 4d 45 47 c9 77 21 f4 9b 78 8f 46 2c   VF..MEG.w!..x.F,
0110  fa e1 08 8b 49 40 2e 70 e2 c3 15 f1 fe 2e 50 ab   ....I@.p......P.
0120  00 ab 77 18 3e f2 e0 56 7b 41 9a 39 78 de 4a e4   ..w.>..V{A.9x.J.
0130  aa 8d bf c8 79 b3 f9 86 75 8a 18 0f 03 00 00 00   ....y...u.......
0140  20 00 00 00 28 00 00 00 50 55 42 4b 4d 49 4e 54    ...(...PUBKMINT
0150  4d 41 58 54 b4 f2 07 3c f9 a5 f4 f0 d2 e5 03 51   MAXT...<.......Q
0160  1a cb b0 31 2f e3 cd 83 b7 14 ef 64 eb bb 9c 3b   ...1/......d...;
0170  4c 69 3a ea dc 8e c5 6a 00 00 00 00 5c e0 c6 6a   Li:....j....\..j
0180  00 00 00 00 00 00 00 00                           ........
    Data [truncated]: 524f55474854494d7c0100000700000040000000440000006400000064000000a80000004001000053494700564552004e4f4e4350415448535
2455043455254494e445873d4d35632f7d103283135bf1814ea6e62749958cab285bf1f0bcaa14e061c4aea0be09c93125b7d79231
    [Length: 392]
Voyons maintenant les mises en œuvre concrètes de ce protocole, côté client et côté serveur. D'abord, un avertissement : le RFC vient de sortir, le projet de norme a eu plusieurs itérations et vous trouverez donc en ligne divers programmes qui n'interagissent pas toujours entre eux (par exemple, le logiciel client de Cloudflare ne fonctionne pas avec le serveur public de Cloudflare). Il faudra donc attendre un peu que tout soit d'équerre. En attendant, jouons un peu. D'abord, le logiciel de Cloudflare, écrit en Go (vous pouvez aussi lire leur documentation) :
% git clone https://github.com/cloudflare/roughtime.git
% cd roughtime
% cd cmd/getroughtime
% go build main.go
% ./main
Either provide a configuration via -config or an address via -ping
Ah, c'est logique, rappelez-vous ce que j'ai écrit sur la liste de
serveurs (et leurs clés, cf. sections 8.1 et 8.3 du
RFC). getroughtime sait utiliser une liste écrite en JSON. Le RFC décrit le
format dans sa section 8.3, et on utilise le
type
application/roughtime-server+json si on la
distribue en ligne. Un exemple figure dans l'annexe A. Il y a une
liste fournie dans le logiciel, utilisons-la :
% ./main -config ../../ecosystem.json
skipped Cloudflare-Roughtime-2: protocol: response is missing NONC tag
skipped int08h-Roughtime: no reply
skipped roughtime.se: no reply
time.txryan.com: 2026-10-06 09:36:47 +0000 UTC ±3s (in 96ms)
Delta: -741ms
Bon, plusieurs des serveurs ne répondent pas, ou pas correctement selon les clients (ma remarque ci-dessus à propos des différentes versions qui trainent). Mais le dernier marche, et on a bien l'heure. Le même logiciel contient aussi un serveur de test :
% cd ../testserver
% go build main.go
% ./main
main.go:64: Root public key: zFVzPprRDxDOMdsrifp+/XPkVkDEhllv6QDJxOWWYd0=
Le serveur tourne (par défaut, sur
127.0.0.1:2002). Notez que le
port officiellement enregistré
à l'IANA est désormais 5319. Et le serveur nous affiche sa
clé. Essayons en indiquant cette clé :
% cd ../getroughtime
% ./main -ping localhost:2002 -pubkey zFVzPprRDxDOMdsrifp+/XPkVkDEhllv6QDJxOWWYd0=
Ping response: 2026-10-06 11:37:57.754243 +0200 CEST ±1s (in 1ms)
Parfait, tout va bien. Si on avait indiqué une mauvaise clé :
% ./main -ping localhost:2002 -pubkey kMe//FBOFOwPXjx8NYjPtkdlH94IoxAX98RDsiVXcEc=
Ping error: protocol: invalid delegation signature
Le client vérifie donc bien les signatures du serveur. Essayons avec un autre logiciel, écrit en C :
% git clone https://github.com/nahojkap/craggy.git
% cd craggy
% cmake -E make_directory ./build
% cmake -S . -B ./build/ -DCRAGGY_WITH_ORLP_ED25519_BINDINGS=ON
% cd build
% make
Le client ne fonctionne pas avec le serveur de test de Cloudflare (qui meurt avec « main.go:97: Error while handling request: no version in common: [] ») mais il marche avec au moins un serveur public :
% ./cli/craggy-cli -h  time.txryan.com:2002 -k iBVjxg/1j7y1+kQUTBYdTabxCppesU/07D4PMDJk2WA=

Received reply in 105898μs. (105ms)
Current time is 1791281389ms from the epoch, ±3s
System clock differs from that estimate by -796785μs. (-796ms)
Il existe aussi d'autres mises en œuvre que je n'ai pas testées,
chez
Google en Go, une autre en C
et une
dernière, en Clojure. Si vous cherchez
des serveurs publics pour tester, vous avez une
liste (pas à jour…) dans le code de Cloudflare. Ou bien vous
en trouvez quelque part sur le réseau, par exemple le serveur expérimental de SIDN. Je
copie la configuration qu'ils indiquent, je l'édite pour changer la
version en IETF-Roughtime (car le client testé ne
connait pas encore la version 1) et ça marche avec le logiciel de
Cloudflare :
% ./main -config /tmp/sidn.json
TimeNL-Roughtime: 2026-10-07 17:06:30 +0200 CEST ±3s (in 24ms)
Delta: -658ms
Autres lectures :
- L'explication de Cloudflare et la documentation du logiciel,
- une courte explication claire des buts du protocole par un des auteurs du RFC et une présentation qu'il avait faite au RIPE pendant le développement du protocole,
- la vidéo d'une autre présentation du projet,
- le résultat des tests du protocole à un hackathon de l'IETF en 2024,
L'article seul
La conférence « Histories of tracking » 2026
Première rédaction de cet article le 5 octobre 2026
Du 30 septembre au 2 octobre, j'ai eu le plaisir de participer à la conférence Histories of Tracking à l'université du Luxembourg. Cette conférence était consacrée à la surveillance exercée sur les utilisateurices, notamment dans le contexte du numérique. Voici quelques notes sommaires.
La conférence n'était pas diffusée en ligne ni enregistrée (donc
pas de surveillance possible 🤣). On y retrouvait des vieux
souvenirs comme le champ de l'en-tête HTTP Do Not
Track, jamais réellement respecté par les
serveurs. Sebastian Gießmann a dit qu'aujourd'hui, c'était plutôt
Do Always Track. (La technique de préservation de
la vie privée recommandée
aujourd'hui est le champ Sec-GPC, enregistré
à l'IANA.) 
Matthew L. Jones a commencé par une introduction sur l'histoire de la surveillance via les métadonnées. L'orateur a bien insisté sur le fait frappant que les lois sur la capture de données et la surveillance, même rejetées, finissent toujours par revenir sur la table au premier fait divers. Lutter contre ces lois est épuisant, c'est un jour de la marmotte perpétuel.
Cecilia Passanti a expliqué l'histoire de la biométrie en Afrique depuis les indépendances, lorsque des entreprises européennes comme Sinorg or Gallia profitaient de ces nouveaux marchés, sous prétexte, par exemple, de garantir l'absence de fraude aux élections, pour tester leurs produits, qu'elles allaient ensuite vendre dans le « Nord global ».
Rebecca Ciesielski a parlé entre autres de l'affirmation souvent entendue comme quoi les ordiphones écoutent en permanence et qu'on reçoit ensuite de la publicité en fonction de conversations qu'on a eu près d'un ordiphone allumé. Elle conclut que c'est techniquement possible (les applications doivent notifier qu'elles écoutent mais, si l'écran est éteint, cela ne se voit pas) mais pas prouvé, on n'a que des anecdotes (« je parlais de chaussures de sport avec ma compagne et j'ai eu tout à coup des publicités pour Nike »), et il est difficile de savoir si la régie publicitaire n'avait pas d'autre source (une utilisation d'un moteur de recherche juste avant ?).
Une partie particulièrement intéressante pour moi, car je ne connaissais pas le sujet, a été celle sur la surveillance des animaux. Christoph Borbach a décrit les systèmes de suivi de la faune sauvage, qui doivent être bien acceptés par ces « utilisateurs involontaires ». J'ai appris que les ratons laveurs sont particulièrement efficaces pour retirer leurs dispositifs de surveillance et que les pies coopèrent pour s'enlever ces exaspérants bagues et colliers. Et Vesna Schierbaum a fait un très bon exposé sur un sujet que je ne connaissais pas du tout, le « virtual fencing » ou, au lieu de mettre le bétail derrière des barrières physiques, on équipe les animaux d'un dispositif (connecté à l'Internet) qui les guide. C'est très peu utilisé en Europe mais courant en Argentine, en Nouvelle-Zélande, aux États-Unis, etc. Elle a cité deux entreprises, Monil et Halter. Le plus gros investisseur de la deuxième est Peter Thiel… Outre les questions sur le bien-être animal et sur la déshumanisation du travail des paysans, je note que ces dispositifs sont chers et enferment davantage les fermiers dans la dépendance technologique. Sans compter ce qui se passerait en cas de panne ou de piratage.
Moritz Feichtinger a présenté ses travaux sur les systèmes de surveillance militaires. (Et a rappelé qu'on pouvait déduire beaucoup de choses des métadonnées.) Saviez-vous que l'armée étatsunienne utilisait des drones de surveillance pendant la guerre du Vietnam ? Par contre, contrairement à ce qu'on voit aujourd'hui, en Ukraine, les vidéos n'étaient pas publiées. Un étudiant présent a demandé comment ils pouvaient piloter le drone à distance puisqu'il n'y avait pas encore d'Internet 😊.
La session de clôture a vu Azadeh Akbari présenter un triste bilan de la surveillance en Iran des années 1920 (sous le chah, donc) à aujourd'hui. Dans les prisons (aussi bien celles du chah que celles des mollahs), c'était souvent les prisonniers qui surveillaient, chaque groupe politique ou religieux observant en permanence les membres du groupe.
Ah, et il y a eu aussi l'intervention d'une, artiste, Clio Van Aerde, qui a notamment présenté sa curieuse performance de tour du Luxembourg en suivant strictement la frontière.
De mon côté, je présentais l'évolution, qui est loin d'être linéaire, de la réflexion sur la surveillance et la vie privée à l'IETF, depuis ses débuts. Vous pouvez accéder aux supports (et à leur source, en Typst).
L'article seul
Le rapport de l'ANSSI sur le piratage de la DGFIP
Première rédaction de cet article le 5 octobre 2026
Vous le savez, en ce moment, c'est la fête des fuites de données personnelles en France. Tout le monde (et son chat) a déjà été victime d'au moins une fuite. Au moins, grâce au RGPD, on est informé qu'il y a eu une fuite. Mais que s'est-il passé derrière ? En général, on ne le sait pas. Aucune enquête indépendante publiée et, souvent, rien du tout n'est publié, on doit se fier aux rumeurs propagées par des influenceurs en cybersécurité sur les réseaux sociaux, par des ministres menteurs et par des journalistes ignorants. Mais le piratage de la DGFIP, il est vrai particulièrement scandaleux, fait, lui, l'objet d'une publication assez détaillée, par l'ANSSI.
Je vous recommande fortement la lecture de ce
rapport. Bien sûr, ce n'est pas une enquête indépendante
(l'ANSSI, c'est l'État) mais c'est bien
écrit (il y a beaucoup de sigles spécifiques à l'État mais un
glossaire est présent), sérieux, modeste (l'ANSSI note bien ses
propres faiblesses) et détaillé (attention, certaines parties ont
été censurées par un gros pavé noir). Mais voici quelques points qui
m'ont frappé (le principal étant le fait que ce rapport existe et
ait été publié). 
Le rapport contient un certain nombre de bons avis de sécurité. Mais beaucoup de gens l'ont interprété de manière binaire, s'indignant que le ministère n'ait pas mis en œuvre telle ou telle mesure. C'est oublier le principe de base de la sécurité (pas seulement informatique) : il n'y a pas de solution idéale, seulement des compromis. Par exemple, un EDR (mentionné par l'ANSSI) consomme des ressources informatiques importantes, a des faux positifs (j'en ai vu un protester contre du code binaire SuperH, considéré comme forcément suspect, alors que du code Sparc ou Alpha dans le même répertoire ne posait pas de problème), et peut avoir des bogues (c'était d'ailleurs le scénario du dernier exercice Remparts). Pire, ce sont souvent des logiciels privateurs. Bref, ne pas avoir d'EDR a des inconvénients, en avoir un a des inconvénients. On peut juste choisir son poison.
Le même raisonnement peut être appliqué aux autres conseils de l'ANSSI. Bien sûr, ils sont tous raisonnables mais tous ont un coût, pas seulement financier, mais aussi en gêne des employés pour leur travail. Les organisations qui déploient les mesures citées ont souvent été victimes d'une « auto-attaque par déni de service », les mesures de sécurité empêchant de travailler.
J'ai quand même trouvé que le cas cité par le rapport d'une soi-disant « authentification à deux facteurs » qui consistait en l'envoi par courrier du second facteur… alors que le courrier était traité sur la machine qui servait à se connecter, était en effet assez incroyable. Si les deux facteurs sont sur la même machine, ce ne sont pas réellement deux facteurs (le rapport insiste, à juste titre, sur ce point).
Le rapport détaille les techniques mises en œuvre mais pas l'arrière-plan organisationnel. Par exemple, au moins une partie des accès pirates ont été faits depuis le ministère de l'Éducation nationale, apparemment moins protégé, mais le rapport ne dit pas pourquoi ce ministère avait accès aux données des impôts. Même chose pour des accès par des entités privées extérieures (comme le géomètre-expert mentionné dans le rapport).
La sécurité ne dépend pas uniquement du budget (on peut avoir un budget très élevé et le dépenser essentiellement dans du théâtre sécuritaire, par exemple l'achat de dispositifs techniques très chers, opaques mais bénéficiant d'un bon marketing). Mais il ne faut pas se faire d'illusion, la sécurité aura un coût : si on déploie toutes les mesures proposées par le rapport, il faudra embaucher beaucoup de fonctionnaires (par exemple pour les investigations suite à une alarme). Les mêmes politiciens qui s'indignent « comment se fait-il qu'il n'y ait pas davantage de sécurité dans les ministères » seront peut-être les premiers à râler si on leur demande d'augmenter le budget de l'État.
Je recommande de bien lire le rapport jusqu'au bout, les annexes contiennent des détails précis, notamment chronologiques. Ils montrent que de nombreuses alarmes avaient été levées et traitées, mais que l'ampleur et le sérieux de l'attaque n'avaient pas été clairement notés (le fameux problème de « relier les points »).
GuiGui a répondu à certains points de cet article.
L'article seul
Fiche de lecture : From Markup to Markdown
Auteur(s) du livre : Jim Hall
Éditeur : Apress / Springer
978-8-8688-2930-7
Publié en 2026
Première rédaction de cet article le 30 septembre 2026
Dernière mise à jour le 4 octobre 2026
Aujourd'hui, bien des gens croient que la seule façon d'écrire un texte (sans le faire générer par un LLM) est d'utiliser un logiciel de traitement de texte graphique comme Writer. Mais il existe une autre méthode, plus ancienne mais toujours valable, les langages de marquage. C'est pour cela que j'ai acheté ce livre, qui retrace l'histoire de ces langages de marquage et vise surtout leur utilisation pour l'écriture de textes technique et scientifiques.
Je le dis tout de suite, j'ai été déçu. Le livre est cher (un peu moins en EPUB ou PDF mais quand même) pour un contenu qui semble surtout fait de divers articles de blog mis bout à bout. Certains de ces articles sont très intéressants, parlant de sujets peu ou pas abordés dans la plupart des sources, mais d'autres sont vraiment minces (TeX et LaTeX expédiés en 16 pages, dont de longs copier-coller de la sortie de ces programmes très bavards, ce qui est tout à fait inutile). De même, l'auteur a choisi de publier l'intégralité des programmes d'exemple. Ces programmes sont une très bonne idée, ils rendent plus concrets les cas discutés mais les mettre dans le livre, plutôt que sur un site Web à part, était une mauvaise idée.
Le livre commence avec Runoff, ancêtre de ces langages de marquage. Vous plongerez dans l'archéologie avec ce système, créé « juste après que nous ayons cessé de chasser les mammouths avec des outils de pierre ». (Vous pouvez d'ailleurs lire sa très intéressante histoire sur le blog de l'auteur.) Runoff date de l'époque où les impressions sortaient d'une grosse imprimante à laquelle les utilisateurs n'avaient pas accès directement. Pour vous dire mon âge, j'ai travaillé avec un tel système à l'INRETS dans les années 1980 et il y avait encore des opérateurs dont le principal travail était de sortir les listings de l'imprimante et de les déposer dans des casiers au nom des utilisateurs. Runoff était écrit en MAD et vous avez du code source en MAD p. 14 à 16. Dans les pages suivantes, l'auteur ré-implémente Runoff en C. L'exercice est intéressant (et fournira sans doute des bonnes idées de travaux pratiques à bien des enseignants) mais est sans doute trop détaillé, surtout si vous connaissez déjà C. L'auteur dit que cette partie est lisible par quelqu'un qui n'est pas programmeur, que tout est expliqué, ce qui est vrai mais me laisse quand même sceptique. C n'est pas le langage le plus lisible…
Puis Runoff évolue, des descendants apparaissent, l'auteur détaille nroff et même ses macros -ms. (Là encore, point personnel, j'ai écrit des documentations en -ms. Des RFC ont été écrits avec nroff, cf. RFC 2223, section 20.) Autant cette partie est importante historiquement, autant lister autant de macros -ms était à mon avis excessif.
Puis le monde change et les traitements de
texte modernes apparaissent. (Mais sans jamais avoir
remplacé les langages de marquage.) Le premier cité est évidemment
WordStar. J'apprends dans ce livre qu'en plus
de ses menus, il avait aussi des marques (dot
commands), très inspirées de celles de nroff, comme les
premiers navires à vapeur, qui gardaient mâts et voiles au cas
où. On pouvait donc formater ses documents Wordstar avec des
.PA et .HE inclus dans le
texte (p. 155 à 156)… L'auteur décrit ensuite le format sous lequel
WordStar enregistre ses documents et écrit un programme en
C pour les lire. (Les
logiciels de traitement de texte modernes ont un format bien trop
complexe pour que cet exercice soit encore réaliste.) Parmi les
points rigolos de ce format, le remplissage
pour que tout fichier, même vide, contienne toujours un multiple de
128 octets, ce qui facilitait la tâche du programme de
relecture. (Dans cette heureuse époque où on lisait en C des
fichiers venus de l'extérieur sans se demander s'ils ne
déclencheraient pas une faille de sécurité latente.) Mais bon, là
encore, avoir mis tout le code source dans le livre est une mauvaise
idée. (Même remarque pour les affichages de débogage, avec
l'intégralité des octets de remplissage, p. 177.)
Le livre détaille aussi l'histoire de l'impression puisque, à l'époque, il n'était guère envisageable de lire un long texte sur l'écran (et du temps de Runoff, on n'avait même pas toujours un écran). Le papier était donc crucial, et le livre explique le fonctionnement d'une imprimante matricielle puis crée une émulation en logiciel (toujours en C) d'une telle imprimante, permettant d'afficher sur l'écran à quoi aurait ressemblé un texte imprimé sur une telle machine. S'il y a dans ce livre de nombreuses pages passionnantes sur des points peu connus, là encore, l'auteur détaille trop.
Enfin on en arrive à HTML mais la partie sur le Web contient vraiment des erreurs énormes. Dire (p. 231) que le premier navigateur Web date de 1994 alors qu'il a cinq ans de plus, par exemple. Ou ne pas citer le CERN une seule fois et prétendre que le Web a été inventé à l'UIUC, ce qui est grave. Sinon, sur le Web, notez qu'on peut parfaitement écrire des documents complexes, y compris des livres, joliment formatés avec les techniques du Web comme le fait C&F Éditions. L'auteur décrit aussi Markdown, une alternative légère à XML et HTML (RFC 7764), et développe un logiciel de conversion de Markdown vers HTML.
Le livre se termine par une présentation du système de gestion de documents XML DITA dont je ne vois pas trop l'intérêt, il ne semble pas faire grand'chose de plus que XInclude ou des techniques similaires comme les entités XML. Puisqu'on parle de XML, j'en profite pour me faire de la publicité et dire que mon livre a été écrit en XML.
Le livre concerne surtout le passé, vous n'y trouverez pas des systèmes récents comme Typst. Les langages de marquage ne sont pas une survivance du passé mais un domaine très actif et très utilisé (par exemple pour ce blog).
Plusieurs personnes ont proposé des ajouts intéressants à cet article. Thierry Stoehr recommande de lire les articles sur le blog de l'auteur, qui parle de beaucoup de sujets liés à l'écriture, entre autres de documentation technique (comme cet article sur le Linotron). Il recommande aussi les vidéos de Computerphile comme celle sur SGML, XML et HTML.
De son côté, Bertrand Petit recommande, sur les techniques d'impression, « Literature for Composing Linecasters » et « Photocomposition Systems », ainsi qu'une série de vidéos. Il suggère aussi un article sur la reconstruction d'un article historique Joe Condon, Brian Kernighan et Ken Thompson, « Experience with the Mergenthaler Linotron 202 Phototypesetter, or, How We Spent Our Summer Vacation ».
L'article seul
RFC 10050: Protocol-Specific Profiles for JSContact
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : R. Stepanek (Fastmail), M. Loffredo (IIT-CNR)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF calext
Première rédaction de cet article le 24 septembre 2026
La norme JSContact décrit un modèle de données et un format pour stocker des informations de contact sur une entité (personne physique ou morale). Elle est riche, avec beaucoup d'informations dont toutes les applications n'ont pas forcément besoin. Ce RFC normalise la notion de profil : un profil est une spécialisation de JSContact, indiquant les éléments obligatoires et les autres. Un nouveau registre IANA stocke les profils existants.
JSContact est normalisé dans le RFC 9553. Il peut servir par exemple comme modèle de données et format pour un carnet d'adresses, ou dans des protocoles d'accès à l'information sur les contacts d'un objet enregistré, comme RDAP (RFC 9083). On peut échanger du JSContact avec des protocoles comme CardDAV (RFC 6352) ou JMAP (RFC 9610). JSContact vise à remplacer vCard (RFC 6350) et sa déclinaison jCard (RFC 7095), complexes et difficiles à traiter.
Mais JSContact a ses propres complications ; comme il a un modèle de données riche, pour pouvoir gérer tous les cas prévisibles, une mise en œuvre de JSContact doit traiter des données même quand l'application n'en a pas l'usage (sans compter les problèmes de vie privée que peut poser cette absence de minimisation des données). Le RFC 9553 permet d'ignorer certaines données, mais uniquement celles d'extension de JSON, pas les données du cœur.
La solution de notre RFC est de permettre la définition de profils, un profil étant une définition de ce qui est nécessaire dans un objet JSContact. Ainsi, une application qui n'a besoin que de peu de données peut utiliser JSContact au lieu de définir son propre format. Le registre central permettra de trouver et de référencer facilement les profils. (Aujourd'hui, aucun n'est enregistré.)
Un profil est donc un ensemble d'éléments JSContact, stocké dans le registre IANA. Il a un nom (restreint à ASCII). Notez bien qu'un même objet JSContact peut être valide selon plusieurs profils et c'est pour cela que le profil n'est pas affiché dans l'objet.
Un profil liste plusieurs propriétés, qui ont notamment un nom, un contexte (à quel type d'objets s'applique le profil), des restrictions sur les attributs… Par exemple, cette propriété :
 Property Name: kind Property Context: Card Restricted Enum
  Values: individual,org
s'applique aux objets
Card et dit que kind (RFC 9553, section 2.1.4) ne peut être que
individual ou org (et pas,
comme normalement en JSContact, group,
application, etc).
Je l'ai dit, le registre actuel est vide donc, pour avoir des exemples, il faut regarder les annexes A.1, A.3 et A.4 (profil) ainsi que A.2 (objet JSContact correspondant à ce profil) du RFC. Pour ajouter des profils au registre, la politique à suivre (RFC 8126) est « Spécification nécessaire ».
L'article seul
RFC 10032: The AEGIS Family of Authenticated Encryption Algorithms
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : F. Denis (Fastly), S. Lucas
Pour information
Réalisé dans le cadre du groupe de recherche IRTF cfrg
Première rédaction de cet article le 19 septembre 2026
L'imagination des cryptologues est sans fin, voici une nouvelle famille d'algorithmes de chiffrement, fondés sur le classique AES, la famille AEGIS (qui, au moment d'écrire cet article, n'a pas encore de page Wikipédia). AEGIS permet de réutiliser le jeu d'instructions AES mais est plus rapide qu'AES et fournit du chiffrement intègre.
AEGIS est issu du concours CAESAR. Il existe en plusieurs versions, AEGIS-128, AEGIS-128L, AEGIS-128X, AEGIS-256 et AEGIS-256X (ils sont désormais dans le registre IANA des algorithmes de chiffrement intègre). Comme leurs noms l'indiquent, ces algorithmes diffèrent par la taille des clés utilisées mais tous utilisent les fonctions de base d'AES (norme NIST.FIPS.197-upd1), ce qui leur permet d'utiliser les mises en œuvre matérielles d'AES. AEGIS peut être vu comme de l'AES plus rapide.
En outre, AEGIS est normalement plus sûr qu'AES en mode GCM (les autres modes d'AES n'offrent pas de chiffrement intègre et ne sont donc pas vraiment comparables). Avec AES-GCM, on peut trouver des textes chiffrés qui se déchiffrent correctement avec plusieurs clés, ce qui facilite certaines attaques (cf. « Partitioning Oracle Attacks). Ce n'est pas possible avec AEGIS. D'autre part, la clé utilisée ne sert qu'au tout début, le chiffrement ou déchiffrement sera fait après une dérivation, on pourra donc effacer la clé de la mémoire rapidement, diminuant les risques qu'un méchant ne la copie.
Si vous voulez en savoir plus, ne comptez pas sur mes faibles connaissances en cryptographie, lisez les sections 2 à 8 du RFC, qui expliquent les algorithmes de la famille AEGIS, avec pseudo-code. Puis, pour approfondir, « Analyzing the Linear Keystream Biases in AEGIS », « Guess-and-Determine Attacks on AEGIS », « Weak Keys in Reduced AEGIS and Tiaoxin » ou « MILP-based security evaluation for AEGIS/Tiaoxin-346/ Rocca ».
AEGIS est aujourd'hui mis en œuvre dans plusieurs bibliothèques logicielles, dans de très nombreux langages de programmation. Si vous voulez contribuer à ces codes, ou bien en créer un nouveau, n'oubliez pas de tester avec les vecteurs de test de l'annexe A (également disponibles en ligne).
Les fans de cryptologie liront avec plaisir la section 9 qui analyse les problèmes de sécurité potentiels d'AEGIS. J'ai noté que cette section estime qu'AEGIS est résistant aux calculateurs quantiques, en tout cas s'il n'y a pas de lien quantique avec le système qui fait tourner AEGIS (ce qu'on appelle traditionnellement le « modèle Q1 d'attaquant », le modèle Q2 étant un attaquant complètement quantique).
L'article seul
Version 18 d'Unicode
Première rédaction de cet article le 18 septembre 2026
Le 16 septembre 2026 est sortie la version 18 d'Unicode. Une description officielle des principaux changements est disponible mais voici ceux qui m'ont intéressé particulièrement. (Il n'y a pas de changement radical.)
Pour explorer plus facilement la grande base Unicode, j'utilise un programme qui la convertit en SQL et permet ensuite de faire des analyses variées. Faisons quelques requêtes SQL :
ucd=> SELECT count(*) AS Total FROM Characters;
 total
--------
 172873
Combien de caractères sont arrivés avec la version 18 ?
ucd=> SELECT version,count(version) FROM Characters GROUP BY version ORDER BY version::float;
...
 15.0    |  4489
 15.1    |   627
 16.0    |  5185
 17.0    |  4803
 18.0    | 13007
13 007 nouveaux caractères, c'est beaucoup par rapport aux précédentes versions, mais ce sont presque tous des sinogrammes du petit sceau. Autrement, quels sont ces nouveaux caractères ?
ucd=> SELECT To_U(codepoint) AS Code_point, name FROM Characters WHERE version='18.0' ORDER BY Codepoint;
 code_point |                                    name
-----------+----------------------------------------------------------------------------
…
 U+20C3     | UAE DIRHAM SIGN
 U+20C4     | OMANI RIAL SIGN
 …
 U+A7E2     | LATIN CAPITAL LETTER R WITH LONG LEG
 …
 U+10EF3    | ARABIC SMALL HIGH NOON WITH FATHA
 …
 U+12477    | CUNEIFORM NUMERIC SIGN ASH TIMES ONE DISH TENU
 …
 U+18E17    | JURCHEN CHARACTER-18E17
 …
 U+1FA8B    | METEOR
 U+1FA8C    | ERASER
 U+1FA8D    | NET WITH HANDLE
 U+1FACC    | MONARCH BUTTERFLY
 U+1FADD    | PICKLE
 …
 U+3D005    | SEAL CHARACTER-3D005
 …
On y voit quelques nouveaux caractères, ainsi que les trois nouvelles écritures de cette version d'Unicode, les anciens chiffres cunéiformes, le jurchen et le petit sceau. Et il y a aussi quelques changements de comportement, qui nécessiteront un peu de mise à jour des bibliothèques logicielles.
En plus futile, il y a l'habituelle arrivée d'emojis comme le cornichon (comme dans la chanson) et le météore. Le trognon de pomme n'a toujours pas été intégré (il avait déjà été retiré d'Unicode 17).
Si vous avez les bonnes polices de caractères, vous allez pouvoir voir quelques exemples (sinon, le lien mène vers Uniview). Voici par exemple, le rial omanais , une nouvelle lettre R utilisée pour le xhosa, , une marque utilisée pour l'arabe, un chiffre cunéiforme , une lettre jurchen , une lettre du petit sceau , la gomme et le monarque .
Et sinon, en bien plus détaillé qu'ici, vous pouvez aussi lire l'article d'Ysabeau.
L'article seul
RFC 10033: Hash-based Signatures: State and Backup Management
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : T. Wiggers (PQShield), K. Bashiri
(BSI), S. Kölbl (Google), J. Goodman
(Crypto4A Technologies), S. Kousidis
(BSI)
Pour information
Réalisé dans le cadre du groupe de travail IETF pquip
Première rédaction de cet article le 15 septembre 2026
Certains algorithmes de cryptographie sont à état, c'est-à-dire que les programmes qui les utilisent doivent se souvenir des exécutions précédentes de l'algorithme ; refaire tourner l'algorithme dans les mêmes conditions serait une faille de sécurité. Cette nécessité de mémoriser un état complique évidemment leur utilisation. Ce nouveau RFC documente les bonnes pratiques à ce sujet.
La question des algorithmes à état est particulièrement cruciale dans le contexte de la cryptographie post-quantique. Un problème de beaucoup d'algorithmes post-quantiques est la grande taille de leurs clés et de leurs signatures, ce qui pose problème pour certaines applications sur l'Internet. Une solution possible serait d'utiliser des algorithmes comme ceux fondés sur la condensation, qui ont des clés et des signatures de taille plus raisonnable, et reposant sur ces algorithmes de condensation, qui sont bien connus. Mais ces algorithmes sont à état, ce qui est vraiment pénible à gérer.
Il existe plusieurs algorithmes dans cette famille fondée sur la condensation : LMS (Leighton–Micali Signatures), HSS (Hierarchical Signature System), XMSS (eXtended Merkle Signature Scheme), etc. Tous résistent aux futurs calculateurs quantiques mais tous ont un défaut : signer deux fois avec la même clé permet à la cryptanalyse de découvrir la clé privée. Il faut donc dériver une nouvelle clé à chaque signature et se souvenir des clés précédentes, pour ne pas risquer de réutilisation. C'est évidemment très contraignant et cela explique pourquoi, par exemple, ces algorithmes n'ont pas été sérieusement envisagés pour DNSSEC.
Si vous voulez vous instruire sur ces algorithmes utilisant la condensation, lisez les RFC 8391 (sur XMSS), RFC 8554 (sur LMS) et la norme NIST SP 800-208. Dans ces algorithmes, la clé privée est en fait une série de clés, partant d'une graine et créées par dérivations successives. L'état est simplement un index vers cette liste, indiquant la dernière clé utilisée. Si on réutilise une clé, on dévoile la graine. Il est donc très important de garder trace de l'index, de l'état. À chaque signature effectuée, il faut le mettre à jour. Imaginez par exemple un dispositif de signature qui signerait, diffuserait le message signé mais subirait ensuite une coupure de courant qui l'empêcherait de mettre à jour l'état. Une fois le courant revenu, la signature suivante utilisera le même index, donc la même clé et paf, le ou la cryptanalyste qui lira les deux signatures et connait la clé publique pourra trouver la graine, donc la clé privée. (Si ça vous semble magique, lisez « State Management for Hash- Based Signatures », « State management for stateful authentication mechanisms », « Oops, I did it again – Security of One-Time Signatures under Two-Message Attacks » et « Oops, I did it again revisited: another look at reusing one-time signatures ».) Notre RFC est donc consacré à décrire les mesures qui peuvent empêcher cette situation. Il faut s'assurer que l'état est bien mis à jour à chaque signature, que, dans le cas où il y a plusieurs signeurs, ils ne puissent jamais utiliser la même clé et que si on restaure les sauvegardes, on ne se trouve pas à réutiliser une clé. C'est compliqué ? Oui, et c'est pour cela que les algorithmes à état sont peu populaires. (Ils avaient été envisagés pour DNSSEC mais avaient fait peur à tout le monde.) Comme le note la section 1.1 du RFC, ces algorithmes ne conviennent pas pour un usage généraliste, il faut les réserver à des cas bien précis.
On peut même se demander pourquoi ces algorithmes n'ont pas été jetés à la poubelle tout de suite. C'est parce qu'ils ont quand même certains avantages, comme des tailles de clés et de signatures raisonnables. (DNSSEC, cité plus haut, ne peut pas envisager les énormes clés et signatures de ML-DSA.) Un exemple d'utilisation des systèmes à état est donné dans le RFC 9802.
La section 2 du RFC rappelle la terminologie utilisée. La clé privée à proprement parler est la graine dont dérivent les clés de signature. Elle-même est sans état et a potentiellement une longue durée de vie. Elle se gère comme n'importe quelle clé privée (donc, vous ne la mettez pas sur GitHub). L'état est au contraire à courte durée de vie et est mis à jour à chaque signature. Sa gestion (le mettre à jour, le sauvegarder, le distribuer…) est toute la difficulté des algorithmes de cryptographie à état.
Place à la pratique en section 3. Par exemple, les sauvegardes. Sauvegarder une clé qui peut servir pendant 10 ou 20 ans est une chose. Mais, ici, il faut sauvegarder du matériel cryptographique qui change tout le temps, puisque sauvegarder l'état est indispensable. La section 3.2 est une bonne lecture si vous vous intéressez aux questions de préservation de contenu numérique.
Mais il y a aussi le problème des procédures à suivre. Gérer des clés avec état est plus complexe et nécessite du personnel qualifié et consciencieux. Cela a des conséquences lorsqu'on calcule le coût total d'une solution cryptographique. D'autant plus que la sécurité peut nécessiter davantage de personnel, par exemple lorsqu'on déploie une solution M-sur-N pour contrer le risque d'une attaque menée de l'intérieur.
La section 4 liste les conséquences de ces exigences sous forme d'exigences ACID : la solution déployée doit permettre des transactions tout-ou-rien : l'utilisation de la signature et la mise à jour de l'état doivent être dans la même transaction (atomicité).
Suivre ces exigences en logiciel va être difficile : il peut y avoir une mémorisation de certaines informations, ce qui signifie que la version stockée sur un support stable n'a pas été mise à jour, il peut y avoir copie d'une machine virtuelle vers une autre, l'état étant alors dupliqué, etc. Le RFC conseille de plutôt utiliser un composant matériel dédié pour cette tâche délicate de maintien de l'état. Mais si vous voulez vraiment étudier la question en détail, et notamment les différents moyens d'atteindre nos objectifs, la section 5 discute de nombreuses solutions possibles.
Le RFC note aussi que ces exigences ne s'appliquent qu'au signeur. Le vérificateur des signatures, lui, peut complètement ignorer le problème et ne pas connaitre l'état.
L'article seul
Faire un lien symbolique immuable sur Linux
Première rédaction de cet article le 9 septembre 2026
Hier, j'ai cherché à faire un lien
symbolique « immuable » sur
Linux, plus exactement un lien que son ou sa
propriétaire ne risquerait pas de supprimer par accident, tout en
lui permettant de créer et détruire d'autres objets dans ce
répertoire. Si vous connaissez Linux, vous allez probablement crier
« chattr +i, chattr
+i ! ». Mais, non, cela ne marche pas.
Essayons quand même, sur le compte d'un utilisateur nommé Bob. D'abord avec un fichier ordinaire :
$ echo "Contenu sans intérêt" > myfile

$ sudo chattr +i myfile

$ ls -l myfile
-rw-rw-r-- 1 bob bob 23 Sep  9 15:12 myfile
$ lsattr myfile
----i---------e------- myfile

$ rm myfile
rm: cannot remove 'myfile': Operation not permitted
Parfait, tout marche (une alternative à sudo aurait été
la capacité
CAP_LINUX_IMMUTABLE mais c'est une autre
histoire). Essayons maintenant avec un lien symbolique :
$ ln -s /etc/motd mylink

$ sudo chattr +i mylink
chattr: Operation not supported while reading flags on mylink
Bon, c'est raté, chattr ne marche pas sur les liens symboliques. (Le message exact dépend de votre libc ; vous aurez peut-être plutôt « Symbolic link loop ».) En tout cas, ça ne marche pas sur Linux. (Il parait que cela fonctionne sur FreeBSD.)
Comment faire, alors ? Changer le propriétaire du lien ne change rien car la suppression est une opération sur le répertoire. Le propriétaire du répertoire peut supprimer des fichiers qui ne lui appartiennent pas. Et changer le propriétaire du répertoire ne suffit pas, car on veut que Bob puisse continuer à lire et à écrire dans ce répertoire. Le sticky bit seul ne suffirait pas non plus, il empêche de supprimer les fichiers des autres, pas les siens.
ChatGPT a finalement trouvé une solution, mais à la troisième itération, après quelques idées qui ne marchaient pas (ChatGPT, comme tout utilisateur des réseaux sociaux, ne teste pas ses idées avant de les publier ; « You're right », « Yes. Your suspicion is exactly correct ») :
$ ln -s /etc/motd mylink
$ sudo chown root:bob .
$ sudo chmod +t .
$ sudo chmod g+w .
$ sudo chown --no-dereference root:root mylink

$ rm mylink
rm: cannot remove 'mylink': Operation not permitted

$ ls -alt
total 8
drwxrwxr-t 2 root bob  4096 Sep  9 15:26 .
lrwxrwxrwx 1 root root    9 Sep  9 15:26 mylink -> /etc/motd
drwxr-x--- 3 bob  bob  4096 Sep  9 15:25 ..
Détaillons cette solution. On met
root comme propriétaire
du répertoire (on peut aussi utiliser un autre utilisateur que
root) mais le groupe est bob, un groupe
qui inclut Bob. On met ensuite le sticky bit. On
donne au groupe le droit d'écriture dans le répertoire. Et enfin on
change le propriétaire du lien pour que cela ne soit pas Bob (notez
le --no-dereference sans lequel
chown essaierait de changer la
cible du lien et pas le lien). Et Bob ne peut plus supprimer le
lien, tout en pouvant lire et écrire dans le répertoire.
L'article seul
A history of the Arpanet - The first decade ; une lecture
Première rédaction de cet article le 5 septembre 2026
En 1981, la société BBN a écrit pour la DARPA (ex-ARPA) un rapport de 184 pages « A history of the Arpanet - The first decade » qui faisait le bilan des dix (en fait plutôt onze et demi) premières années du réseau Arpanet. Cela reste un des meilleurs documents pour celles et ceux qui veulent comprendre comment marchait l'Arpanet, qui n'était pas du tout un Internet en plus petit, mais un réseau assez différent.
Rappelez-vous la date, 1981. Le rapport
est tapé à la machine et vous ne trouverez
pas de version
machine-readable, vous
n'aurez qu'une image. 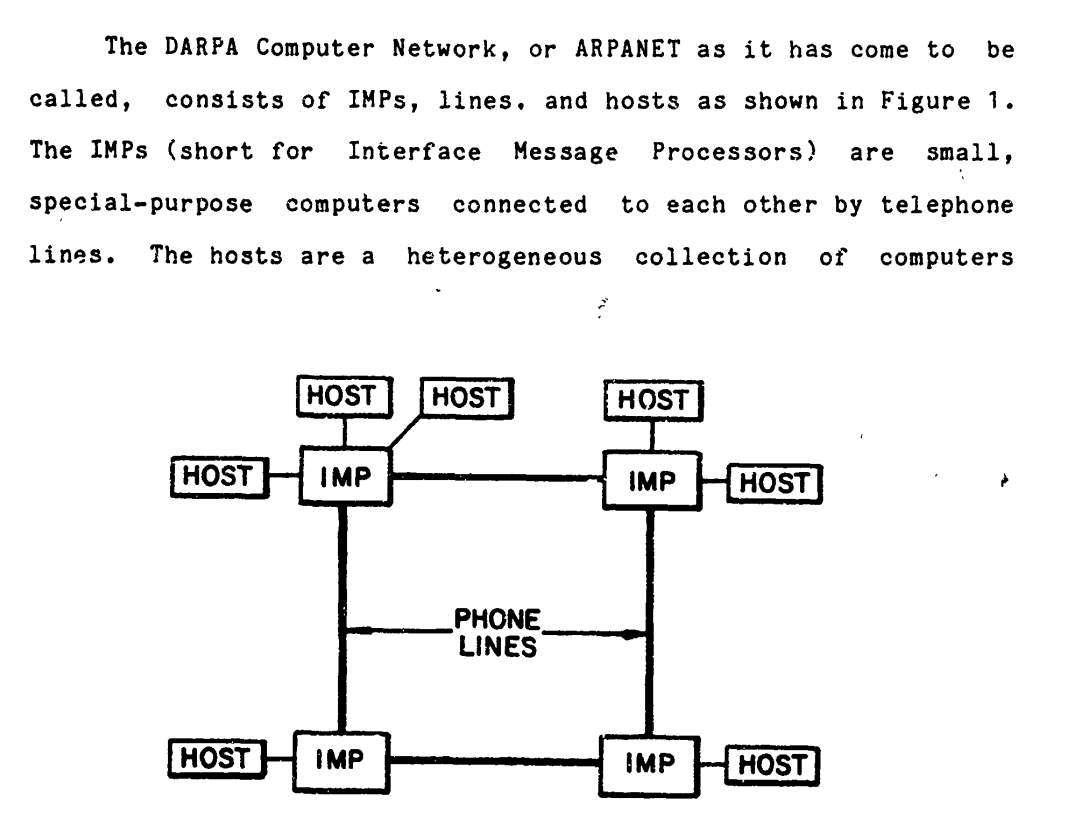
Le rapport détaille les objectifs (vous n'y trouverez pas la légendaire « nécessité de résister à une attaque nucléaire »), l'histoire, et la technique. Arpanet était très expérimental et les débuts ont été plutôt agités.
Contrairement à l'Internet, l'Arpanet
était un réseau très homogène (je parle du réseau, pas des
ordinateurs qui y étaient connectés) et très centralisé. Par
exemple, tout l'Arpanet était supervisé depuis un point unique (le
routage, par contre, était décentralisé). Et le
choix des liens entre les sites était décidé centralement, optimisé
par un programme développé spécialement (dont l'histoire ne semble
pas avoir gardé le code source…). La technique a évidemment beaucoup
progressé et on rit aujourd'hui des efforts pour développer du
matériel spécifique nécessaire pour calculer des sommes
de contrôle à la vitesse ébouriffante de 50 kb/s. Bon,
je rigole mais il faut se rappeler que, pour les concepteurs de
l'Arpanet, presque tout était nouveau et que plein de choses ont dû
être inventées. Le code des IMP (en très gros
l'équivalent des routeurs)
était écrit en langage d'assemblage, pour les
performances, et très optimisé. 
Le rapport est globalement positif mais il est intéressant de noter qu'il mentionne aussi les points où l'Arpanet a des problèmes et des limites : le problème de la congestion (qui ne sera traité que bien plus tard, le rapport parle d'ailleurs du développement de TCP), la difficulté à concevoir des protocoles pour les machines terminales (les IMP étaient tous identiques donc leur cas était plus facile) ou la difficulté de la gestion centralisée des ressources (la liste des services disponibles aurait dû être un document unique, centralisé, ce qui a craqué rapidement).
Si certains points portent la marque de leur époque et font
sourire aujourd'hui, d'autres sont toujours très importants comme la
constatation que « it is possible that this social
feasibility demonstration is as important as the many technical
feasability demonstrations », conclusion qui reste très
vraie sur l'Internet aujourd'hui. 
Outre son grand intérêt historique, je recommande la lecture de
ce rapport à toutes celles et tous ceux qui s'intéressent à la
conception de réseaux informatiques, et aux innombrables choix qu'il
faut faire. Tout est intéressant dans ce rapport mais je vous
signale particulièrement, vers la fin, la discussion sur pourquoi
Arpanet a été un succès (en gros, des gens brillants, beaucoup
d'argent, et pas trop de bureaucratie). 
Les origines militaires de l'Arpanet font que ce rapport était à l'origine à diffusion restreinte mais a été déclassifié depuis. Malgré cela, il n'est pas toujours facile à trouver. Voici quelques endroits possibles :
- Dans la National Security Archive,
- Et bien sûr, sur l'Internet Archive.
L'article seul
RFC 10042: Post-Quantum/Traditional Hybrid Key Exchange with the Module-Lattice-Based Key-Encapsulation Mechanism for Use in SSH
Date de publication du RFC : Août 2026
Auteur(s) du RFC : P. Kampanakis (AWS), D. Stebila
(University of Waterloo), T. Hansen
(AWS)
Pour information
Réalisé dans le cadre du groupe de travail IETF sshm
Première rédaction de cet article le 31 août 2026
Tout le monde (et son chat) se met à la cryptographie post-quantique en ce moment et plus précisément à des systèmes hybrides, c'est-à-dire utilisant à la fois un algorithme traditionnel (comme ECDH) et un algorithme post-quantique (comme ML-KEM). Ce RFC décrit l'échange de clés avec un système hybride dans le protocole SSH.
Au début d'une connexion SSH (RFC 4251, section 1), les deux parties qui communiquent procèdent en effet à un échange de clés (section 7 du RFC 4253) afin de parvenir à un accord sur la clé partagée qui sera utilisée pour chiffrer la communication. Jusqu'à récemment, cet échange de clés était fait en utilisant un algorithme reposant sur les courbes elliptiques (RFC 5656 et RFC 8731), algorithme qui est vulnérable aux futurs calculateurs quantiques. Si des calculateurs quantiques réellement utilisables (les CRQC, Cryptographically Relevant Quantum Computers) apparaissent un jour, l'ancien algorithme devra être abandonné. Et on ne peut pas attendre pour voir si des CRQC deviennent réellement disponibles : des attaquants sont peut-être aujourd'hui en train d'enregistrer des sessions SSH, afin de les décrypter plus tard lorsqu'on aura enfin des CRQC (RFC 9958, section 1). Bref, il vaut mieux passer à des algorithmes post-quantiques dès maintenant.
Mais les algorithmes post-quantiques existants ne sont pas forcément sûrs face à la cryptanalyse ; on manque de recul à ce sujet. D'où l'idée de systèmes hybrides (RFC 9794), ou PQ/T (pour PostQuantum/Traditional) combinant algorithme post-quantique et algorithme traditionnel, et obligeant l'attaquant à casser les deux s'il veut décrypter la communication. (Si vous voulez creuser la question de la sécurité des systèmes hybrides, regardez « Security of Hybrid Key Encapsulation » et « Security of Hybrid Key Establishment using Concatenation ».) C'est ce genre de système que normalise notre RFC. Il est sûr face à un attaquant actif, même si ce dernier dispose d'un calculateur quantique ou bien s'il a trouvé une faille dans l'algorithme post-quantique.
Plus précisément, ce RFC va utiliser l'algorithme post-quantique ML-KEM avec un choix d'algorithmes traditionnels.
La section 2 du RFC décrit concrètement l'échange de clés avec le
système hybride (relire les RFC 4251 et RFC 4253 peut être utile). Le client SSH, au lieu
de commencer par SSH_MSG_KEXDH_INIT (RFC 4253) ou
SSH_MSG_KEX_ECDH_INIT (RFC 5656), envoie un message
SSH_MSG_KEX_HYBRID_INIT (valeur 30 dans le
protocole) qui contient la concaténation des deux clés du client. Et
la réponse, au lieu de SSH_MSG_KEXDH_REPLY ou
SSH_MSG_KEX_ECDH_REPLY sera un
SSH_MSG_KEX_HYBRID_REPLY (valeur 31 dans le
protocole) contenant la concaténation des deux clés du serveur. Le
choix du mécanisme hybride utilisé est indiqué dans le message
SSH_MSG_KEXINIT (RFC 4253, section 7.1) et peut valoir
mlkem768nistp256-sha256,
mlkem1024nistp384-sha384 ou
mlkem768x25519-sha256 (désormais enregistrés
à l'IANA). Rappelez-vous qu'on parle d'échange de clés (symétriques), pas
d'authentification, la réponse
SSH_MSG_KEX_HYBRID_REPLY contient aussi la clé
publique du serveur, celle qui sert à vérifier qu'on parle au bon
serveur, mais celle-ci n'est pas concernée par ce RFC.
Le mécanisme hybride va nous donner deux secrets partagés, un pour chaque algorithme (le post-quantique et le traditionnel) et le secret qui servira (après dérivation) de clé pour le chiffrement symétrique est la concaténation de ces deux secrets (c'est très proche de ce que fait TLS, dans le RFC 9954).
Un problème classique de la cryptographie post-quantique est la taille des clés, bien plus importante qu'avec les algorithmes traditionnels. (L'hybride est même un tout petit peu plus grand, avec la clé traditionnelle.) SSH a des limites de taille (section 6.1 du RFC 4253) mais les algorithmes spécifiés dans notre RFC ne les atteignent pas.
La section 6 du RFC détaille les conséquences de ce schéma hybride sur la sécurité. Elle conseille par exemple d'utiliser X25519 (RFC 8731) plutôt que les courbes NIST comme P256, pour sa rapidité et sa meilleure résistance aux attaques par canal auxiliaire, sauf si on veut de la conformité plutôt que de la sécurité et qu'on doit utiliser les courbes NIST.
Côté mise en œuvre de ce système hybride,
OpenSSH le connait (ssh -Q
kex pour avoir la liste des algorithmes connus)
et, depuis la version
10.4, « the hybrid post-quantum algorithm
mlkem768x25519-sha256 is now used by default for key
agreement ». Par exemple :
% ssh -v something.bortzmeyer.org
debug1: OpenSSH_10.4p1, OpenSSL 3.6.3 9 Jun 2026
…
debug1: kex: algorithm: mlkem768x25519-sha256
debug1: kex: host key algorithm: ssh-ed25519
debug1: kex: server->client cipher: chacha20-poly1305@openssh.com MAC: <implicit> compression: none
debug1: kex: client->server cipher: chacha20-poly1305@openssh.com MAC: <implicit> compression: none
debug1: expecting SSH2_MSG_KEX_ECDH_REPLY
debug1: SSH2_MSG_KEX_ECDH_REPLY received
…
Hmmm, ça aurait dû être
SSH_MSG_KEX_HYBRID_REPLY, bizarre…
L'article seul
Articles des différentes années : 2026 2025 2024 2023 2022 2021 2020 Précédentes années
Syndication : Flux Atom avec seulement les résumés et Flux Atom avec tout le contenu.